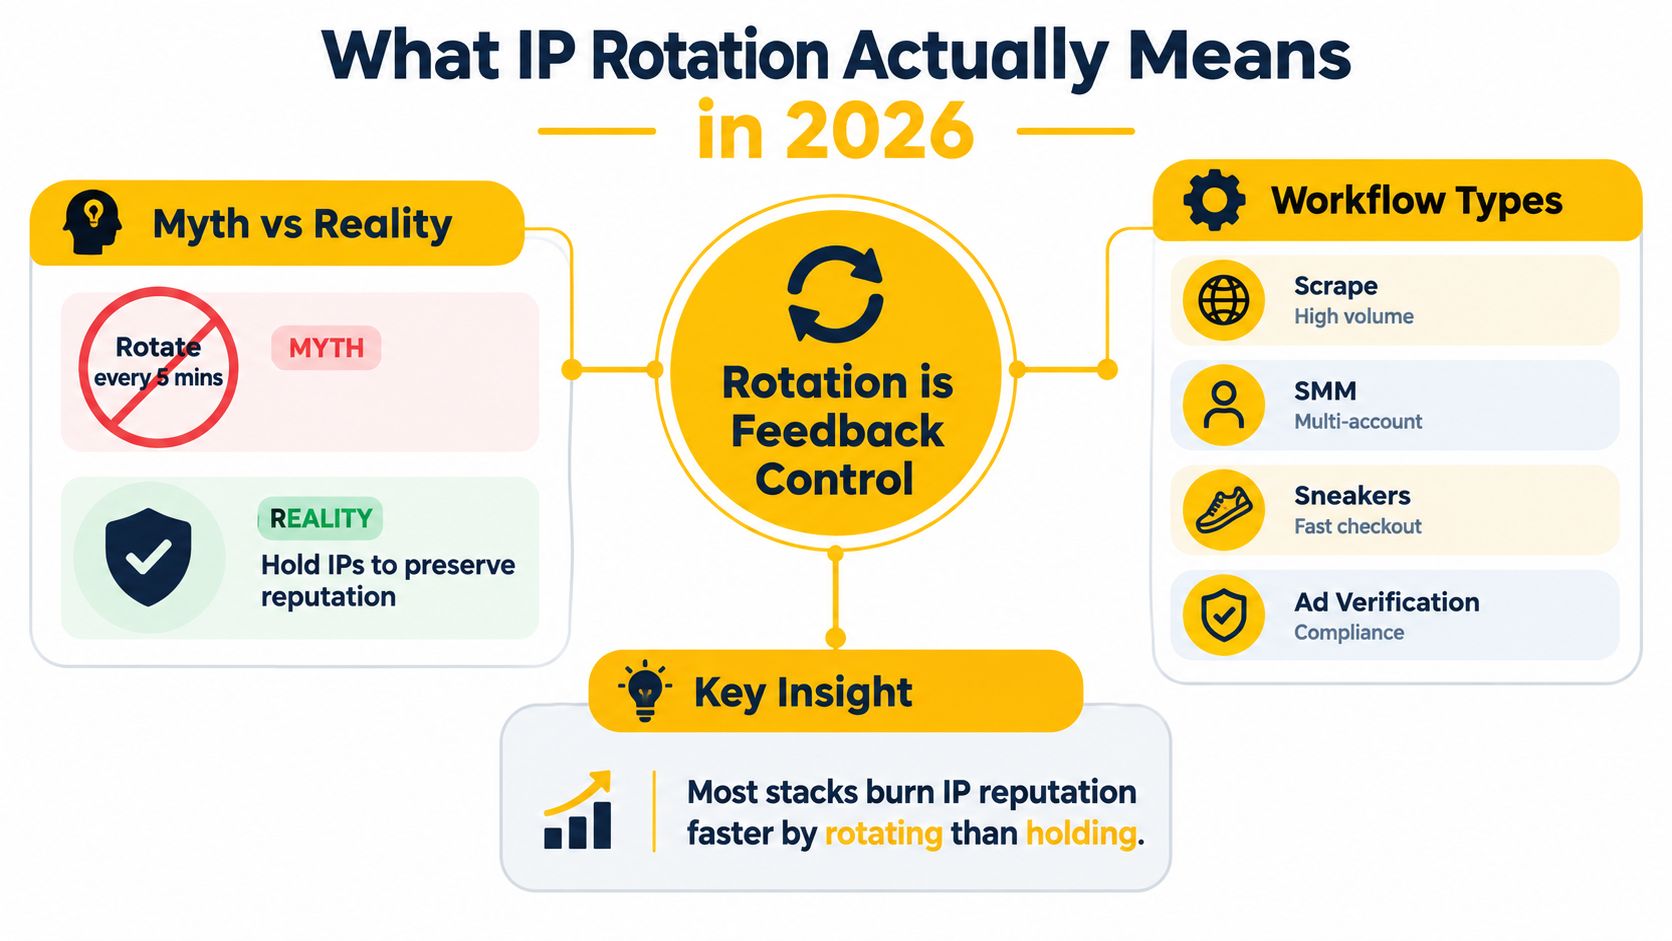
Der häufigste Rat, wie man eine IP-Adresse rotieren kann, ist auch der einfachste Weg, ein funktionierendes Proxy-Setup zu schädigen: alle fünf Minuten rotieren, unabhängig davon, was der Arbeitsablauf tut. Dieser zeitgesteuerte Ansatz ignoriert Sitzungscookies, Authentifizierungsstatus, Carrier-Reputation, Anforderungsrate und die Tatsache, dass ein neuer mobiler Ausgang möglicherweise bereits eine gemeinsame Historie hat.
Eine Produktionsrotationspolitik funktioniert besser als ein Feedback-Kontrollsystem. Sie halten eine Adresse, während eine logische Sitzung Kontinuität benötigt, beobachten Statuscodes, CAPTCHA-Häufigkeit, Latenz und Antwortänderungen und rotieren dann, wenn Risikoindikatoren steigen. Das Ziel ist nicht, IPs so oft wie möglich zu wechseln. Es geht darum, das Netzwerk, den Browser, die Sitzung und das Anforderungsmuster für die Aufgabe kohärent zu halten.
Was IP-Rotation im Jahr 2026 bedeutet
IP-Rotation ändert die öffentliche Adresse, die einem Ziel sichtbar ist. In Produktions-SMM, Scraping, Werbung und QA-Workflows ist diese Definition unvollständig. Eine verwendbare Politik entscheidet auch wann eine Adresse beibehalten werden soll, welche Signale auf steigendes Risiko hinweisen und ob der nächste Ausgang den Netzwerk-, ASN-, geografischen und Protokollanforderungen des Workflows entspricht.
Rotation funktioniert am besten als Feedback-Kontrollsystem, nicht als Timer. Halten Sie eine Adresse, während eine logische Sitzung Kontinuität benötigt, beobachten Sie die Antworten des Ziels und ändern Sie die Ausgänge, wenn die Beweise auf steigendes Risiko hinweisen. Ein angemeldetes soziales Konto, eine authentifizierte QA-Reise und unabhängige öffentliche Datenanforderungen haben unterschiedliche Kontinuitätsanforderungen. Das Ändern eines Ausgangs während einer Multi-Anforderungs-Transaktion kann Cookies ungültig machen, den scheinbaren Netzwerk-Kontext ändern und Betrugsmaßnahmen auslösen, selbst wenn die Ersatzadresse geografisch korrekt ist.
Die Signale, die die Rotation steuern sollten
Ein widerstandsfähiger Controller beobachtet das Verhalten des Ziels und zeichnet das Ergebnis für jeden Ausgang auf:
- HTTP-Statusdrift: Steigende 429-Antworten deuten auf Druck bei der Rate hin. 403-Antworten können auf ein Politik- oder Reputationsproblem hinweisen. Protokollieren Sie beides nach Ausgang, ASN, Workflow und Anforderungsart.
- CAPTCHA-Häufigkeit: Ein plötzlicher Anstieg kann auf einen ungeeigneten Carrier-Ausgang, einen inkonsistenten Browserstatus oder eine übermäßige Anforderungsrate hinweisen.
- Latenzvariationen: Ändern sich die Antwortzeiten, kann das auf eine Überlastung des Carriers, ein kämpfendes Gateway oder eine Route hinweisen, die nicht mit der beabsichtigten Geografie übereinstimmt.
- Änderungen der Antwortgröße: Eine unerwartet kleine oder große Antwort kann auf eine Challenge-Seite, ein Interstitial oder einen teilweisen Fehler hinweisen.
Nach einem Fehler gibt ein exponentieller Rückgang wie 2, 4, 8 und 16 Sekunden dem Controller Zeit, um zu vermeiden, dass die gleiche Bedingung wiederholt wird. Diese Intervalle sind in technischen Anleitungen zur Rotationsstrategie für Proxys dokumentiert. Wiederholte Fehler sollten den Ausgang in eine vorübergehende Quarantäne versetzen, anstatt mehr Verkehr darüber zu leiten.
Die Protokollanpassung beeinflusst ebenfalls das Ergebnis. HTTP-Proxys eignen sich für gewöhnliche Webanforderungen und explizite HTTP-Client-Konfigurationen. SOCKS5 kann breitere TCP-Verkehrstransfers durchführen, aber die Anwendung muss dies korrekt unterstützen, und die DNS-Verwaltung sollte getestet und nicht angenommen werden. Protokollieren Sie das verwendete Protokoll zusammen mit dem Ausgang und ASN, damit ein Routingproblem nicht wie ein IP-Reputationsproblem aussieht.
Mobile Frische ist nicht Einzigartigkeit
Mobile Netzwerke verwenden häufig Carrier-Grade NAT oder CGNAT, wodurch viele Abonnenten einen kleineren Pool öffentlicher IPv4-Adressen teilen können. RFC 6598 reserviert 100.64.0.0/10, das 100.64.0.0 bis 100.127.255.255 abdeckt, für den gemeinsam genutzten Adressraum von Dienstanbietern. Die IETF-Spezifikation für gemeinsam genutzten Adressraum erklärt, dass diese internen Adressen nicht global routierbar sind.
Ein neuer mobiler Ausgang kann daher eine andere IP haben, während er im selben Carrier-ASN bleibt oder eine Reputation erbt, die von nicht verwandten Abonnenten geprägt ist. Überprüfen Sie sowohl die ASN als auch die Adresse. IP-Rotation verteilt die IP-Ebenen-Historie, lässt jedoch Cookies, Browserfingerabdrücke, Geräteattribute, Verhaltensmuster und Anforderungsraten-Signale für Korrelationen verfügbar. Die Abdeckung der Anti-Bot-Erkennung und Scraping-Resilienz erklärt, warum diese Signale über Adressänderungen hinweg bestehen bleiben können.
Praktische Regel: Halten Sie einen Ausgang für eine vollständige logische Sitzung. Rotieren Sie zwischen unabhängigen Überprüfungen oder nach einer abgeschlossenen Transaktion und setzen Sie einen Ausgang in Quarantäne, wenn seine gemessenen Signale sich verschlechtern.
Mobile, Wohn- und Rechenzentrums-Proxys im Vergleich
Der Proxy-Typ bestimmt die Netzwerkidentität hinter der Adresse, nicht nur den Standort, der durch eine IP-Abfrage zurückgegeben wird. Mobile Proxys verwenden 4G, 5G oder andere Carrier-Konnektivität, Wohnproxys verwenden Zugangs-ISP-Netzwerke, und Rechenzentrums-Proxys stammen aus Hosting-Infrastrukturen.
Mobile Adressen können für einige Abwehrmaßnahmen schwerer als automatisiert zu klassifizieren sein, da sie gewöhnlichem Carrier-Verkehr ähneln und nicht konzentrierten Hosting-Bereichen. Das macht sie jedoch nicht unsichtbar oder automatisch vertrauenswürdig. CGNAT bedeutet, dass mehrere Abonnenten eine öffentliche IPv4-Adresse teilen können, sodass eine legitime mobile Sitzung Rate-Limits oder Reputation von nicht verwandten Aktivitäten erben kann. Branchenberichte haben beschrieben, dass CGNAT-Adressen häufiger einer Ratenbegrenzung unterliegen als nicht-CGNAT-Adressen, trotz ähnlicher Bot-Verkehrsniveaus, sodass Teams die tatsächlichen Ergebnisse am Ziel messen sollten, anstatt anzunehmen, dass jeder mobile Ausgang sauber ist. Siehe die Analyse des Verhaltens von mobilen und Wohnproxys.
Wohnproxys bieten in der Regel eine stabilere Zugangs-ISP-Identität, die für standortsensitive Überprüfungen und Workflows geeignet sein kann, die Kontinuität benötigen. Ihr Nachteil ist, dass die Adresse möglicherweise weniger entsorgbar ist und ein Pool gemischte Qualität enthalten kann. Rechenzentrums-Proxys bieten oft Geschwindigkeit und vorhersehbare Kapazität, aber der Besitz des Hosting-Netzwerks kann ein offensichtliches Signal für Systeme sein, die Verbrauchertraffic von Servertraffic unterscheiden.
| Proxy-Typ | IP-Quelle | Rotationsmodell | Am besten geeignet für | Trade-off |
|---|---|---|---|---|
| Mobil | Carrier-Netzwerk mit 4G- oder 5G-Konnektivität | Carrier-Sitzung oder provider-gesteuerte Rotation | Sozialmanagement, Anzeigenüberprüfung, geoabhängige QA | Geteilte CGNAT-Reputation, variable Latenz, begrenzte Kapazität |
| Wohn | Zugangs-ISP oder Heimnetzwerk-Ausgang | Sticky oder geplante Rotation | Marktforschung, Standortüberprüfungen, ausgewählte Einzelhandels-Workflows | Poolqualität variiert, Kontinuität kann schwerer zu garantieren sein |
| Rechenzentrum | Hosting- oder Cloud-Netzwerk | Schnelle geplante oder pro-Anfrage-Rotation | Bulk-Öffentlichkeitsdaten-Sammlung und kontrollierte Tests | Hosting-ASN kann stärkere Überprüfungen anziehen |
ASN ist Teil der Identität
Eine Autonome Systemnummer, oder ASN, identifiziert eine Routing-Domäne, die unter einer definierten Politik betrieben wird. Die ASN-Erklärung der RIPE NCC beschreibt ein autonomes System als eine Routing-Domäne mit einer einzigartigen ASN. Vor einem Test mit hohem Wert validieren Sie die zurückgegebene IP, ASN, Carrier-Metadaten, Reverse-DNS und Geolokalisierung zusammen.
Eine französische Adresse, die von einem unerwarteten Hosting-Netzwerk angekündigt wird, repräsentiert möglicherweise nicht die beabsichtigte mobile Erfahrung. ASN-Überprüfungen zeigen auch, ob ein angeblich vielfältiger Pool in einem engen Netzwerk konzentriert ist. Sie beweisen nicht, dass eine Adresse vertrauenswürdig, mobil oder wohnlich ist.
Die Wahl des Protokolls ist ebenfalls wichtig. HTTP- und HTTPS-Proxy-Endpunkte passen zu Web-Clients und Browser-Anforderungseinstellungen, während SOCKS5 niedrigere Verbindungstransfers für Anwendungen bietet, die breitere TCP-Unterstützung benötigen. Mozillas Dokumentation zur Proxy-Konfiguration unterscheidet diese Optionen. Keines der Protokolle rotiert eine Adresse automatisch. Das Endpoint- oder Sitzungsprotokoll erledigt das.
Für einen praktischen Überblick über die mobile Kategorie siehe was ein mobiler Proxy ist.
Schritt-für-Schritt-Methoden zur Rotation einer IP-Adresse
Beginnen Sie damit, die Transportkonfiguration von der Rotationsrichtlinie zu trennen. Ihre Anwendung sollte wissen, wie sie über den Proxy verbindet, während ein Sitzungsbezeichner oder Anbietersteuerung bestimmt, ob sie denselben Ausgang beibehält oder einen neuen anfordert.
1. Legen Sie den Endpunkt und die Authentifizierung fest
Ein Anbieter stellt typischerweise einen rotierenden Endpunkt zur Verfügung und akzeptiert entweder die Authentifizierung mit Benutzername und Passwort oder eine IP-Whitelist. Halten Sie Anmeldeinformationen außerhalb von Quelldateien und machen Sie den Sitzungsbezeichner explizit, damit die Anwendung absichtlich die Beibehaltung oder einen neuen Ausgang anfordern kann.
Ein abstraktes cURL-Muster sieht so aus:
curl --user "$PROXY_USER:$PROXY_PASS"
--proxy "PROVIDER_ENDPOINT"
"https://target.example/health-check"
Die oben angegebene Ziel-URL ist ein Platzhalter für Ihr autorisiertes Testziel. In der Produktion zeichnen Sie die extern beobachtete Adresse auf, die von einem IP-Überprüfungsdienst zurückgegeben wird, den Sie verwenden dürfen, zusammen mit dem Zeitstempel, dem Netzwerktyp, dem Anbieter, dem Sitzungsbezeichner, dem Statuscode und der Latenz.
2. Verwenden Sie geplante Rotation nur für unabhängige Arbeiten
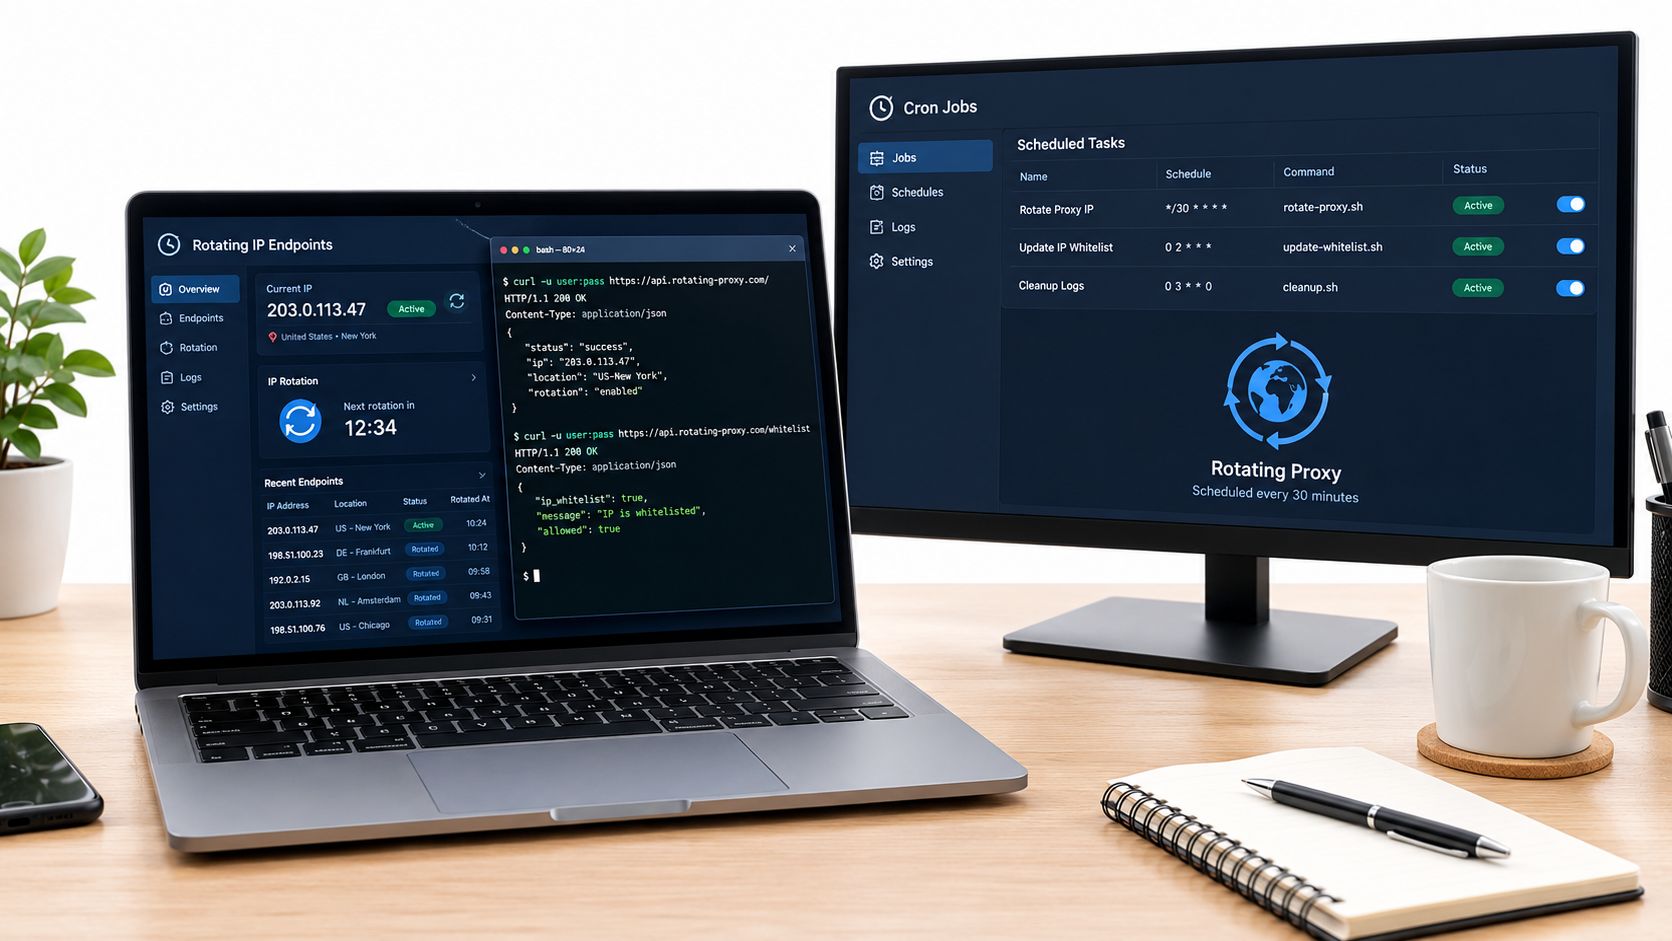
Ein geplanter Job macht Sinn, wenn jede Anfrage logisch getrennt ist, wie z. B. das Überprüfen öffentlicher Seiten an verschiedenen Standorten. Er sollte eine authentifizierte Sequenz nicht unterbrechen. Fordern Sie einen neuen, stabilen Bezeichner über den Rotationsmechanismus des Anbieters an und überprüfen Sie dann die beobachtete öffentliche IP und ASN, bevor Sie fortfahren.
SESSION_ID="$(date +%s)"
curl --user "$PROXY_USER:$PROXY_PASS"
--proxy "PROVIDER_ENDPOINT?session=$SESSION_ID"
"https://target.example/check"
printf '%s %s\n' "$(date -Is)" "$SESSION_ID" >> rotation-events.log
Ein Scheduler kann dieses Skript in einem kontrollierten Intervall aufrufen, aber das Intervall sollte um ein Zielzeitfenster herum randomisiert werden, anstatt genau und wiederholend zu sein. Regelmäßige Zeitabstände sind selbst ein erkennbares Signal, wie die Anleitung zur Proxyrotation erklärt.
3. Auslösen der Rotation auf Anfrage
Die Rotation auf Anfrage ist sicherer, wenn ein Testfall abgeschlossen ist oder der Controller ein bedeutendes Risikosignal sieht. Ein Anbieter kann einen Rotationslink oder eine Sitzungswechselaktion bereitstellen. Verwenden Sie diese Aktion nach einer Transaktion, nicht mitten in einem Login oder Checkout.
curl --fail --user "$PROXY_USER:$PROXY_PASS"
"PROVIDER_ROTATION_ACTION"
curl --user "$PROXY_USER:$PROXY_PASS"
--proxy "PROVIDER_ENDPOINT"
"https://target.example/next-independent-check"
Behandeln Sie die Rotationsantwort als Anfrage, nicht als Beweis. Überprüfen Sie die öffentliche Adresse, ASN, Geolokalisierung, DNS-Verhalten, TLS-Verhalten, Durchsatz und Anwendungs-Kontinuität danach. Eine zehn Tage dauernde NAT-Messung hat ergeben, dass eine öffentliche IP mehrere Stunden stabil bleiben kann, sodass eine erneute Verbindung nicht garantiert, dass sich die sichtbare Adresse geändert hat. Die NAT-Messstudie unterstützt die empirische Validierung des Ergebnisses.
4. Lassen Sie die Anwendung auf Fehler reagieren
Ein Python-Client kann standardmäßig eine Sitzung beibehalten und seinen stabilen Bezeichner nach einem kontrollierten Fehler wechseln. Halten Sie die Header für dieselbe Browser- oder Client-Identität stabil, vermeiden Sie es, jedes Feld zu randomisieren, und verwenden Sie niemals IP-Änderungen, um Zugriffskontrollen zu umgehen.
import time import requests
def fetch(url, session_id): proxy = f"http://USER:PASS@PROVIDER_ENDPOINT?session={session_id}" client = requests.Session() client.proxies.update({ "http": proxy, "https": proxy, }) return client.get(url, timeout=30)
session_id = "logical-session-001" response = fetch("https://target.example/check", session_id)
if response.status_code in (403, 429): time.sleep(2) session_id = "logical-session-002" response = fetch("https://target.example/check", session_id)
Das Beispiel verwendet eine kurze Rückoffzeit nur zur Veranschaulichung des Kontrollflusses. Ein Produktionscontroller sollte exponentielles Backoff verwenden, eine Adresse nach wiederholten Fehlern zurückziehen und Cookies beibehalten, wenn der Workflow sie erfordert. Für mobile spezifische Einrichtungshinweise verwenden Sie diese Anleitung zur Verwendung eines Proxys auf Mobilgeräten.
Stabile Sitzungen, ASN-Überprüfungen und Protokollwahl
Drei Kontrollen entscheiden, ob die Rotation für die Anwendung unsichtbar oder destruktiv ist: Protokollanpassung, Sitzungsaffinität und Netzwerkvalidierung.
HTTP- und HTTPS-Proxys funktionieren gut, wenn der Client bereits Webanfragen versteht und Proxy-Authentifizierung, Weiterleitungen oder Browser-Integration benötigt. SOCKS5 ist besser geeignet, wenn die Anwendung eine verbindungsorientierte Weiterleitung über HTTP-Semantiken hinaus benötigt. Für TLS-intensive Ziele kann ein HTTP CONNECT-Tunnel verschlüsselte Daten übertragen, ohne den Anfrageinhalt an den Proxy offenzulegen, aber jeder zusätzliche Hop kann die Latenz beeinflussen. Testen Sie das DNS-Handling, die Authentifizierung, Weiterleitungen, das IPv6-Verhalten und die Zertifikatsverhandlung im tatsächlichen Client, nicht nur in einer Kommandozeilenüberprüfung.
Eine stabile Sitzung behält einen Ausgang für einen definierten Zeitraum oder bis zur Beendigung. Eine rotierende Sitzung fordert einen anderen Ausgang gemäß einem Zeitplan oder einer expliziten Aktion an. Die Wahl sollte dem Workflow folgen:
| Workflow | Protokoll | Sitzungsmodus | ASN-Überprüfung |
|---|---|---|---|
| Authentifiziertes soziales Management | HTTP oder SOCKS5, basierend auf dem Client | Stabil für die logische Sitzung | Bestätigen Sie den Eigentum und die Konsistenz des Anbieters |
| Unabhängige Anzeigenüberprüfungen | HTTP oder HTTPS | Rotieren zwischen abgeschlossenen Überprüfungen | Validieren Sie Geografie und beabsichtigte Anbieter-ASN |
| Öffentliche Datensammlung | HTTP oder SOCKS5, basierend auf den Bibliotheksbedürfnissen | Kontrollierte Rotation mit Rückoff | Beobachten Sie die Konzentration in einer ASN |
| Geoabhängige QA-Reise | HTTP oder SOCKS5, basierend auf dem Test-Framework | Stabil bis der Testfall endet | Überprüfen Sie Adresse, ASN, Anbieter und Standort |
| Mehrstufiger Einzelhandelsworkflow | HTTP oder HTTPS | Stabil während des Checkouts oder der Testabschluss | Unerwartete Hosting-Netzwerk-Ausgänge ablehnen |
ASN-Validierung fängt falsche Annahmen ein
Eine IP-Abfrage allein kann das richtige Land zurückgeben, während das falsche Netzwerk die Adresse ankündigt. Überprüfen Sie die ASN vor einem wertvollen Anruf, insbesondere wenn der Workflow Werbung, Kontosicherheit oder standortabhängige Inhalte testet. Eine Anbieter-ASN kann immer noch eine gemeinsame Geschichte durch CGNAT haben, sodass die ASN-Validierung mit Herausforderungsraten, Antwortcodes und Sitzungsergebnissen kombiniert werden sollte.
Für Workflows, die von Kontinuität abhängen, ist die Anleitung zur Sitzungspersistenz relevanter als eine einfache Einstellung „jede Anfrage rotieren“. Die IP-Rotation ändert eine Netzwerkvariable. Sie erstellt keine neue Browseridentität, entfernt keine Cookies und autorisiert keinen Zugriff auf einen eingeschränkten Dienst.
Halten Sie die IP, wenn die Anwendung Kontinuität beweist. Rotieren Sie nur, wenn der Workflow eine sichere Grenze erreicht hat oder die Beweise sagen, dass der aktuelle Ausgang Probleme verursacht.
Fallstricke in der realen Sitzung und wie man sie vermeidet
Ein Warm-up eines sozialen Kontos kann ohne einen dramatischen Ausfall fehlschlagen. Der Browser meldet sich über einen 4G-Ausgang an, der Rotations-Timer ändert die Adresse während des authentifizierten Workflows, und der Anbieter weist einen Ausgang zu, den ein anderer Abonnent bereits für missbräuchlichen Verkehr verwendet hat. Die Plattform sieht jetzt einen neuen Netzwerk-Kontext, persistente Cookies, einen unveränderten Gerätefingerabdruck und eine plötzliche Verhaltensänderung. Sie kann das Konto herausfordern oder die Sitzung beenden.
Der Timer verursachte den Fehler, aber der zugrunde liegende Fehler war, das Konto als eine Sequenz unabhängiger Anfragen zu behandeln. Der Zustand des Kontos ist wichtiger als die verstrichene Zeit. Ein Warm-up, ein Veröffentlichungsfluss oder eine Kontosicherheitsüberprüfung sollte seine Sitzungsaffinität beibehalten, bis die logische Aktion abgeschlossen ist.
Drei Fehlerarten
- Fingerprint-Drift: Der Browser und das Gerät bleiben konstant, während das Netzwerk sich wiederholt ändert. Diese Diskrepanz kann verdächtiger wirken als eine stabile mobile Sitzung.
- Cookie-Desynchronisation: Ein Checkout oder authentifizierte Anfrage verliert die Kontinuität, wenn der Exit wechselt. Die Anwendung kann umleiten, den Warenkorb ablehnen oder erneut eine Verifizierung anfordern.
- Gemeinsame Carrier-Reputation: Eine mobile Adresse kann isoliert sauber aussehen, während sie zu einem Carrier-Gateway gehört, dessen Geschichte die Ratenlimits und Herausforderungen beeinflusst.
Verwenden Sie drei Leitplanken. Binden Sie die Rotation an authentifizierte Ereignisse und abgeschlossene Testfälle, nicht an Minuten. Bewahren Sie die Konsistenz von Browser, Gerät, Header und Cookies innerhalb einer Sitzung. Überprüfen Sie die ASN und die beobachtete öffentliche Adresse vor einem wertvollen Anruf, und ziehen Sie dann einen Exit zurück, der wiederholte Fehler verursacht, anstatt ihn wieder in den Pool zu bringen.
Fehlerbehebung bei Blockaden, CAPTCHAs und langsamen Sitzungen
Führen Sie Diagnosen in fester Reihenfolge durch. Beginnen Sie mit 429 und 403-Spitzen, und gruppieren Sie die Ereignisse nach ASN, Sitzung, Ziel und Header-Fingerprint. Wenn Fehler nach ASN gruppiert sind, während der Client-Fingerprint stabil bleibt, könnte die Reputation oder die Carrier-Historie die stärkere Erklärung sein. Wenn sie einem Header-Profil über mehrere Exits folgen, überprüfen Sie zuerst die Konsistenz des Clients und das Anfrageverhalten.
CAPTCHA-Spitzen verdienen die gleiche Trennung. Ein mobiles CGNAT-Pool kann einen schlechten Ruf von anderen Nutzern erben, aber schnelle Anfrageausbrüche und inkonsistente Browsersignale können dasselbe Symptom erzeugen. Vergleichen Sie mehrere Carrier-Exits, reduzieren Sie die Anfragegeschwindigkeit, bewahren Sie den Sitzungsstatus und protokollieren Sie das Ergebnis nach Ziel, anstatt den gesamten Pool als unbrauchbar zu kennzeichnen.
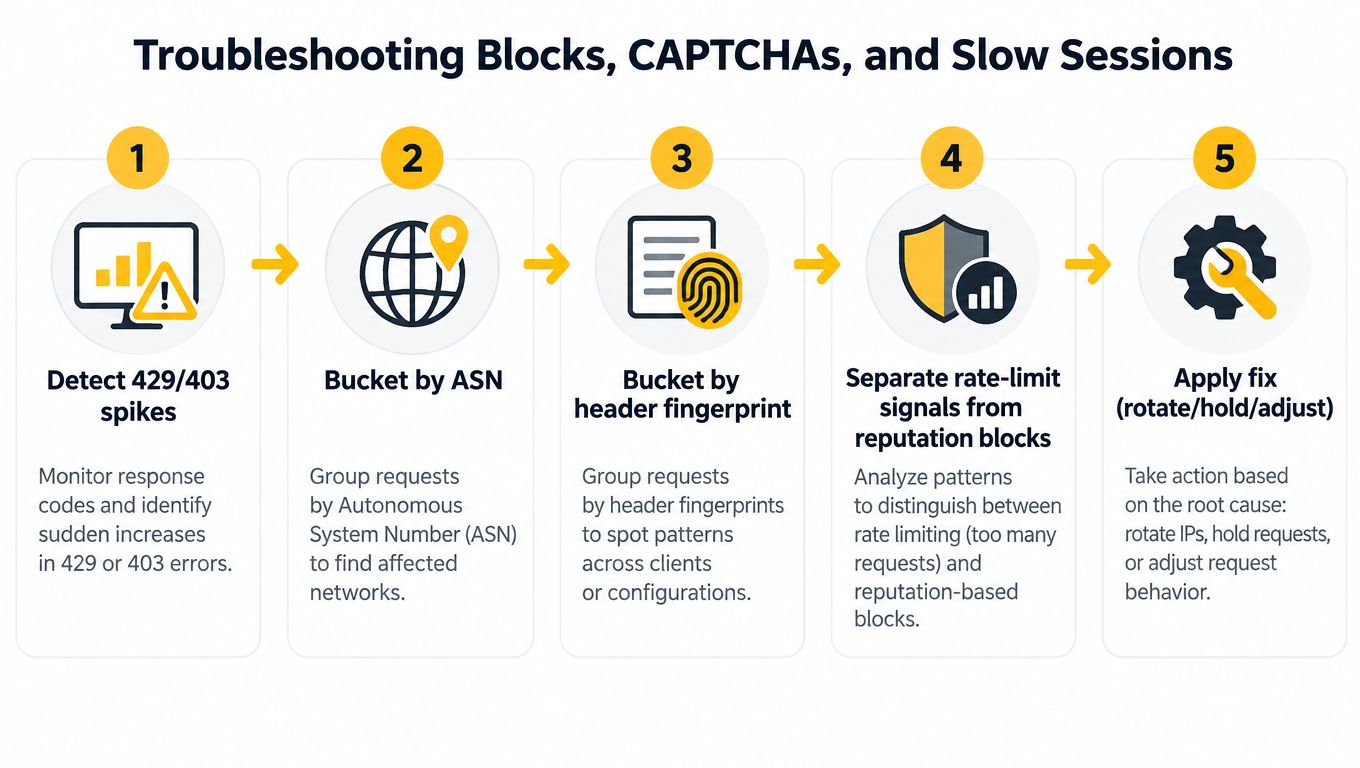
Eine praktische Diagnosereihenfolge
- Änderung der Antwort erkennen: Protokollieren Sie 403, 429, CAPTCHA-Seiten, Antwortgröße und Latenz.
- Nach ASN gruppieren: Trennen Sie Carrier-Exits von Hosting- oder unerwarteten Netzwerken.
- Nach Fingerprint gruppieren: Vergleichen Sie Header, Cookies, TLS-Verhalten und Browserstatus.
- Ursachen trennen: Unterscheiden Sie zwischen Druck auf die Rate und Reputation oder Sitzungsinkonsistenz.
- Eine Lösung anwenden: Halten, rotieren, zurückziehen, den Sitzungsmodus ändern oder den Exit zurückziehen.
Für langsame Sitzungen vergleichen Sie die Zeit bis zum ersten Byte über den Proxy mit einer direkten Basislinie für dasselbe autorisierte Ziel. Überprüfen Sie Retransmits, Verbindungswiederverwendung, DNS-Auflösung, IPv6-Verhalten und SOCKS5-Konfiguration. Eine neue IP behebt kein fehlerhaftes Proxy-Handshake oder einen DNS-Leck.
Verwenden Sie Schwellenwerte nur, nachdem Sie Ihre eigene Basislinie festgelegt haben. Die zuverlässige universelle Antwort ist kein bestimmter Prozentsatz oder Latenzmultiplikator. Es ist eine protokollierte Regel, die angibt, was nach wiederholten Fehlern passiert, wie lange ein Exit zurückgezogen bleibt und wann ein Workflow von rotierendem zu festem Modus wechselt.
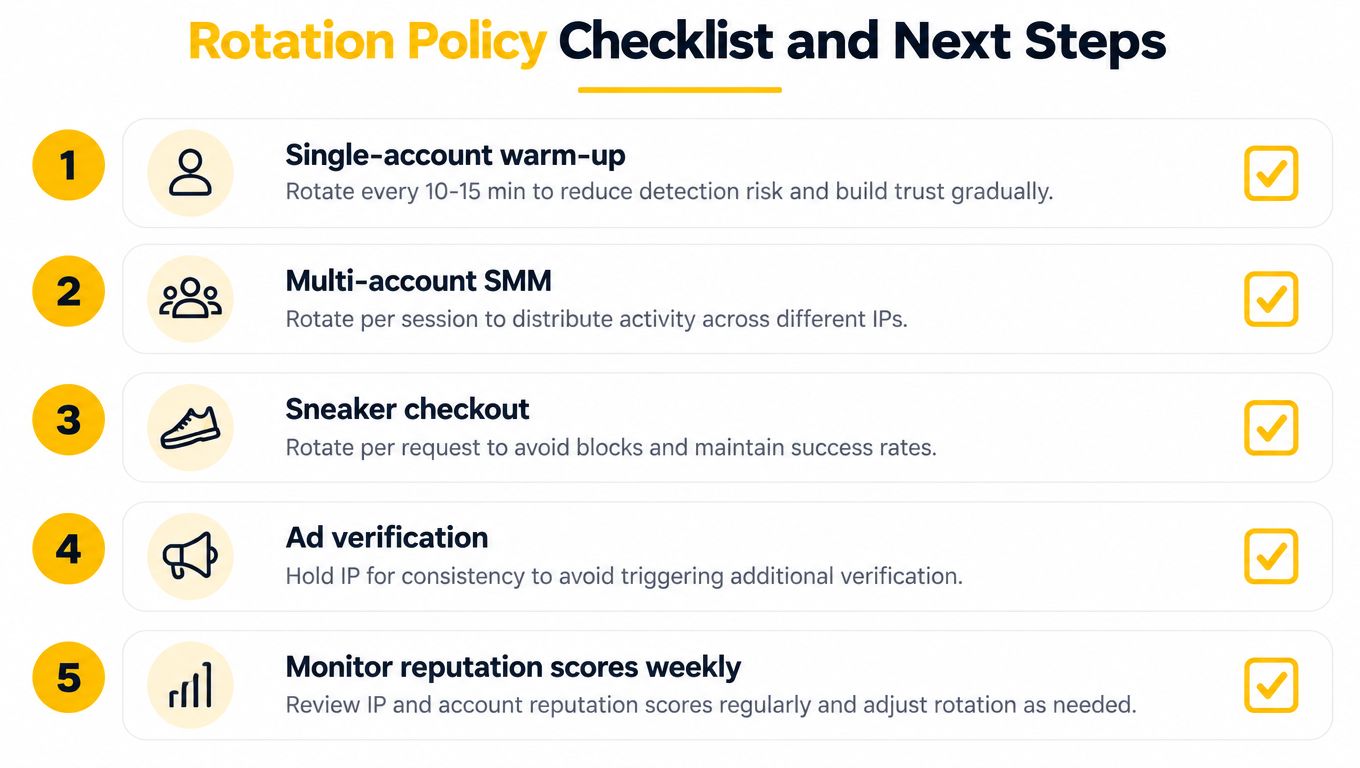
Rotation Policy-Checkliste und nächste Schritte
Eine Produktionsrotation-Politik beginnt mit dem Workflow. Definieren Sie, wann eine Sitzung beginnt und endet, welche Carrier- und ASN-Ergebnisse akzeptabel sind, welche Beweise eine Änderung auslösen und was nach wiederholten Fehlern passiert. Betrachten Sie die Rotation als Feedbacksteuerung: Beobachten Sie die Zielantwort, passen Sie den Exit oder den Sitzungsmodus an und messen Sie dann das Ergebnis.
Die Politik an die Aufgabe anpassen
- Einzelkonto-Warm-up: Halten Sie eine Adresse durch jeden authentifizierten Aktivitätsblock. Rotieren Sie an der Grenze einer abgeschlossenen Aufgabe, niemals während des Logins oder der Kontosicherheitsprüfungen.
- Multi-Account-SMM: Geben Sie jedem Konto seine eigene logische Sitzung. Wechseln Sie die Exits nicht während eines aktiven Veröffentlichungsflusses.
- Sneaker- oder Einzelhandels-Checkout: Bewahren Sie die Kontinuität von der Warenkorberstellung bis zum autorisierten Checkout-Test. Die Rotation pro Anfrage unterbricht zustandsbehaftete Transaktionen.
- Anzeigeüberprüfung: Rotieren Sie zwischen unabhängigen geografischen Überprüfungen und überprüfen Sie dann, ob die Adresse und ASN mit dem beabsichtigten Markt übereinstimmen.
- Markenüberwachung: Verwenden Sie kontrollierte Rotation für separate öffentliche Beobachtungen und ziehen Sie sich zurück, wenn ein Ziel Ratenlimits signalisiert.
- SEO-Rangverfolgung: Halten Sie das Anfragevolumen konservativ, halten Sie die Client-Einstellungen stabil und rotieren Sie, nachdem jede Standortüberprüfung abgeschlossen ist.
Pre-Flight-Checks
Vor Produktionsverkehr testen Sie den Gesundheitsendpunkt des Anbieters, die beobachtete Geolokalisierung, ASN- und Carrier-Metadaten, Authentifizierung, IP-Whitelist, DNS- und IPv6-Verhalten sowie die Parallelitätsgrenzen pro Gateway. Bei mobilen Proxys kann CGNAT viele Nutzer hinter verwandter Carrier-Infrastruktur platzieren, sodass ein IP-Wechsel keine neue Netzwerkidentität garantiert. Überprüfen Sie die ASN und den Carrier, nicht nur die Adresse.
Halten Sie einen Teil des Pools für fehlgeschlagene oder abkühlende Exits bereit. Eine praktische Reserve beträgt etwa 30% bis 50%, was mit den betrieblichen Richtlinien zur Größenordnung und Rotation von Proxy-Pools übereinstimmt. Dimensionieren Sie die Reserve nach der Sensitivität des Workflows und der Wiederherstellungszeit, anstatt denselben Timer für jede Aufgabe anzuwenden.
Protokollieren Sie jede Rotation mit ihrem Zeitstempel, Workflow- und Sitzungsidentifikatoren, öffentlicher IP, ASN, Carrier, Ziel, Status, CAPTCHA-Ergebnis, Latenz und Grund. Diese Aufzeichnungen zeigen, ob der Exit, das Protokoll oder die Politik den Fehler verursacht haben. Verwenden Sie HTTP für einfache Anfrage-Clients und SOCKS5, wenn die Anwendung eine breitere Verbindungsebene-Proxys benötigt, und überprüfen Sie dann die DNS-Verarbeitung für das gewählte Protokoll.
Mobile 4G-Proxys eignen sich für Arbeitslasten, die Carrier-Geografie, kontrollierte Änderungen und stabile Sitzungen benötigen. Evoproxy bietet persönliche und gemeinsame mobile Ports, geplante oder bedarfsgesteuerte IP-Änderungen sowie französische 4G/LTE/3G-Konnektivität für Social Management, Anzeigeüberprüfung, Marktforschung und geoabhängige QA.
Für SMM, Anzeigeüberprüfung, SEO-Überwachung oder QA wählen Sie feste mobile Sitzungen oder bedarfsgesteuerte Änderungen an den Grenzen abgeschlossener Aufgaben. Überprüfen Sie Evoproxy auf Optionen, die Ihren Sitzungs- und Geografieanforderungen entsprechen.


