La semaine d'audit expose généralement le même schéma. Une équipe dit qu'elle a couvert le RGPD parce que le service juridique a approuvé l'avis de confidentialité l'année dernière, l'ingénierie a ajouté une bannière de cookies, et la sécurité a effectué un examen ponctuel. Puis viennent les questions difficiles. Pouvez-vous prouver qu'une demande de suppression a atteint les sauvegardes ? Quels systèmes détiennent encore d'anciennes données de prospects ? Votre pipeline de formation de modèle a-t-il un chemin d'effacement après le retrait du consentement ? Qui a testé le transfert du formulaire d'entrée au processeur en aval ?
C'est là que les tests de conformité au RGPD cessent d'être un exercice de politique et deviennent un exercice d'ingénierie.
Pour les équipes gérant des comptes sociaux à travers les régions, validant la livraison d'annonces, surveillant les prix, grattant des signaux de marché publics, ou testant la qualité des flux localisés, l'écart est encore plus marqué. Vous traitez souvent avec plusieurs processeurs, des interfaces spécifiques à la région, des pipelines automatisés, et des parcours utilisateurs dépendants de la localisation. Les obligations légales sont les mêmes, mais les modes de défaillance sont opérationnels. Un état de consentement qui ne se synchronise pas, une file d'attente DSAR qui supprime des demandes sans préavis, ou un travail de conservation qui saute le stockage d'objets peut annuler beaucoup de documentation soignée.
Pourquoi les tests de conformité au RGPD méritent un véritable programme
Les organisations qui rencontrent le plus de difficultés ne sont que rarement celles qui n'ont pas de documentation. Ce sont celles qui traitent les tests comme une case à cocher annuelle.
Une séquence d'échec typique semble familière. Le support reçoit une demande de suppression et ferme le ticket après avoir retiré l'utilisateur de l'application de production. Le marketing a toujours la personne dans un CRM hérité. Les journaux d'analyse contiennent encore des identifiants. Un flux de travail interne d'IA a copié des enregistrements sources dans un ensemble de données de formation ou d'évaluation, et personne n'a défini comment l'effacement devrait se propager là. Lorsque un régulateur ou un client demande des preuves, l'équipe a des captures d'écran, pas une trace de contrôle.
Cette approche ne tient pas dans un environnement réglementaire qui a déjà produit environ 7,1 milliards d'euros d'amendes cumulées au titre du RGPD dans 2 685 cas documentés, avec la base de données atteignant 3 062 cas lorsque des amendes partiellement spécifiées sont incluses, selon les chiffres et statistiques du CMS GDPR Enforcement Tracker. Cela compte parce que l'application de la loi à cette échelle change la façon dont les équipes matures testent. Elles ne demandent pas seulement si une politique existe. Elles demandent si le contrôle fonctionne dans des conditions de défaillance ordinaires.
Règle pratique : Si un contrôle ne peut pas être relancé, prouvé et lié à une obligation légale, il n'est pas assez mature pour la semaine d'audit.
La loi elle-même vous donne des principes et des obligations, pas une seule méthodologie de test. La Commission européenne est claire que seul le texte du RGPD a force obligatoire, tandis que le matériel d'orientation est explicatif, non contraignant. C'est pourquoi un programme solide relie chaque test à un devoir spécifique au lieu de prétendre qu'un outil ou une configuration est “conforme au RGPD” par lui-même. Voir l'aperçu de la protection des données de la Commission européenne.
La boucle en quatre phases qui fonctionne dans la pratique
J'ai trouvé que les programmes les plus fiables fonctionnent comme une boucle de contrôle avec quatre parties :
Définir le périmètre et cartographier Identifier les systèmes, processeurs, catégories de données, bases légales, chemins de transfert et flux de travail à haut risque.
Tester les contrôles de confidentialité essentiels Valider le consentement, la minimisation, l'accès, l'exportation, la suppression et la conservation dans des parcours réalistes de bout en bout.
Valider les mesures de sécurité techniques Vérifier les mesures de sécurité, la couverture des journaux, les restrictions d'accès et la préparation à la réponse aux incidents.
Rapporter et itérer Stocker les preuves, assigner des remédiations, relancer les assertions échouées et intégrer les nouveaux traitements dans le cycle suivant.
Pourquoi cela importe pour les équipes de croissance technique
Si vous exécutez des campagnes géo-ciblées, des vitrines localisées, des opérations de comptes sociaux ou de vérification d'annonces, votre traitement change souvent. De nouvelles pages de destination apparaissent. De nouveaux champs d'analyse sont ajoutés. De nouvelles régions sont testées. Ce renouvellement est exactement la raison pour laquelle les examens uniques vieillissent mal.
Les tests de conformité au RGPD fonctionnent lorsqu'ils sont construits comme des tests de qualité pour les contrôles de confidentialité. Répétables. Versionnés. Liés au changement.
Définir le périmètre, cartographie des données et décider si une DPIA est requise
Commencer trop tard est une erreur courante. Les tickets de test sont ouverts avant que l'organisation ne sache où les données personnelles entrent, où elles se déplacent et quels systèmes héritent du risque d'un traitement en amont.
Une structure fonctionnelle est un programme en phases de 12 semaines. Un modèle pratique commence par les semaines 1 à 2 pour la découverte automatisée des données personnelles et la cartographie des flux de données, puis priorise les systèmes à haut risque tels que les données de catégorie spéciale, les applications accessibles sur Internet, les portails clients, les API, les systèmes d'identité et le stockage partagé avant les outils internes à faible risque et les pipelines de journaux. Cette séquence est décrite dans ce flux de travail de test de conformité au RGPD. Même si votre calendrier exact diffère, la logique est solide. Testez d'abord les systèmes les plus susceptibles de créer un impact matériel sur la confidentialité.
Ce qu'il faut cartographier avant de tester
Votre inventaire doit être suffisamment clair pour que les ingénieurs puissent le mettre à jour et suffisamment spécifique pour qu'un conseiller ou un DPO puisse le réviser. J'utilise des champs comme ceux-ci :
Nom du système Application produit, CRM, plateforme de support, entrepôt, bucket de stockage d'objets, registre de modèles ou file d'attente.
Catégorie de données Données de compte, données comportementales, données de catégorie spéciale, données d'employés, données d'enfants ou données de profil dérivées.
But du traitement Authentification, prévention de la fraude, mesure des annonces, support client, personnalisation, analyse, formation ou QA.
Base légale Consentement, contrat, obligation légale, intérêts légitimes, etc.
Règle de conservation Période de conservation indiquée, événement déclencheur, méthode de suppression et chemin d'exception.
Limite du processeur Système de contrôleur interne, processeur, sous-processeur ou flux de travail partagé.
Détails du transfert Chemin de transfert transfrontalier et mécanisme de transfert le cas échéant.
Chemin d'effacement Suppression directe, pierre tombale plus purge, expiration de sauvegarde ou non pris en charge.
Si votre équipe gère également l'automatisation ou la collecte de données publiques, gardez vos normes de collecte documentées. Une référence de politique concise comme les lignes directrices sur l'éthique du web scraping aide à séparer la recherche de marché légitime et le QA des pratiques de données négligées.
Les décisions DPIA ont besoin d'une véritable règle
La phrase la plus faible dans de nombreux programmes de confidentialité est “nous ne pensions pas que cela représentait un risque élevé.” Cela ne résistera pas à l'examen par lui-même.
Une meilleure approche est de tester contre les cas présomptifs de l'article 35(3) et les critères de style EDPB qui indiquent un risque élevé probable. Les orientations actuelles mettent également en évidence une nuance que les équipes manquent : si vous vous fiez à un seul critère pour dire qu'aucune DPIA n'est nécessaire, documentez ce raisonnement. Voir cet explicatif sur le déclencheur DPIA.
Matrice de décision de déclenchement DPIA de l'article 35(3)
| Cas présumé (Art. 35(3)) | Condition testable | Seuil de comptage des indicateurs | Preuves à capturer |
|---|---|---|---|
| Évaluation systématique et extensive avec traitement automatisé | Profils des personnes pour influencer l'éligibilité, le classement ou le traitement matériel | DPIA présumé | Logique de décision, champs utilisés, effets de sortie, chemin de révision humaine |
| Traitement à grande échelle de données de catégories spéciales ou hautement sensibles | Stocke ou analyse des données de santé, biométriques ou de données similaires sensibles à grande échelle | DPIA présumé | Inventaire des données, modèle d'accès, conservation, liste des processeurs |
| Surveillance systématique des zones accessibles au public | Observe le comportement de manière persistante ou large | DPIA présumé | Portée de la surveillance, champs de données, chemin de notification, durée de stockage |
| Utilisation de technologies innovantes ou nouvelles | Les changements d'IA ou d'automatisation modifient le risque, l'inférence ou la traçabilité | Deux indicateurs ou plus | Entrées du modèle, sources de formation, chemin de désinscription, méthode d'effacement |
| Enfants ou groupes vulnérables impliqués | Le traitement affecte les utilisateurs avec un pouvoir ou une conscience réduits | Deux indicateurs ou plus | Définition du segment utilisateur, chemin de consentement, garanties |
| Décisions automatisées avec effet significatif | La sortie affecte les droits, l'accès ou les résultats matériels | DPIA présumé | Processus d'appel, chemin d'intervention humaine, journaux d'audit |
Documenter le chemin “sans DPIA”
Lorsque vous concluez qu'aucune DPIA n'est requise, notez-le de la même manière disciplinée que vous documenteriez une DPIA requise.
Capture :
- Quels cas présumés ont été testés
- Quels critères étaient présents ou absents
- Pourquoi le seuil n'a-t-il pas été atteint
- Quelle garantie a réduit le risque résiduel
- Qui a approuvé la décision et quand
- Quel changement futur rouvrirait l'analyse
Un mémo court et daté “aucune DPIA requise” avec des raisons est bien plus fort qu'une hypothèse non écrite que tout le monde oublie six mois plus tard.
Tests de contrôle de base pour le consentement, les DSAR et la conservation
De nombreux programmes cessent de sembler polis et commencent à montrer s'ils fonctionnent.
Les cas de test les plus utiles ne sont pas abstraits. Ce sont des affirmations avec des preuves. Si votre public comprend des équipes sociales, des opérations publicitaires ou des ingénieurs QA, pensez en termes qu'ils utilisent déjà : déclencheur, sortie attendue, sortie observée, retour en arrière et preuve.
Tests de consentement qui détectent le véritable dérive
Les échecs de consentement proviennent souvent d'états non concordants à travers l'interface, la couche de balisage, les événements d'application et les processeurs en aval.
Je veux généralement des preuves de ces conditions :
Le choix granulaire existe L'interface sépare les catégories au lieu de regrouper tout dans un seul état d'acceptation.
La parité de retrait existe Révoquer le consentement n'est pas plus difficile que de l'accorder. Le même utilisateur peut inverser le choix par un chemin direct, pas par un processus de support enfoui.
La propagation de l'état fonctionne Une fois que le consentement change, le comportement de collecte en aval se met à jour de manière cohérente à travers les scripts, les SDK et les exports.
La logique régionale est correcte La bannière, le texte de notification et l'état par défaut correspondent à la région de l'utilisateur et au contexte de traitement.
Une affirmation utile se lit comme suit : “Étant donné un utilisateur dans la région X qui refuse le consentement à l'analyse, les charges utiles d'événements après actualisation n'incluent pas les identifiants d'analyse optionnels, et les exports en aval reflètent le même état.” Les preuves sont un enregistrement d'écran, un échantillon de journal d'événements, un enregistrement de l'état de consentement et une vérification d'exportation.
Les tests DSAR doivent être exécutés de bout en bout
Une demande d'accès ou de suppression de sujet est l'endroit où les systèmes fragmentés sont exposés. DLA Piper a rapporté environ 1,2 milliard d'euros d'amendes GDPR émises en 2025 seulement, portant le total cumulé à environ 7,1 milliards d'euros d'ici le 10 janvier 2026, tandis que les notifications de violation ont atteint une moyenne de 443 par jour, en hausse de 22 % d'une année sur l'autre et marquant la première fois que la moyenne quotidienne a dépassé 400 depuis le début du GDPR, selon le sondage sur les amendes GDPR et les violations de données de DLA Piper. Ce schéma est une des raisons pour lesquelles les tests matures mettent désormais l'accent sur l'exécution des flux de travail, la journalisation et la rapidité de réponse plutôt que sur une simple révision avant lancement.
Pour les DSAR, ne testez pas seulement l'entrée. Testez la chaîne complète :
Intake de la demande La demande peut-elle être soumise de manière fiable par le chemin public et le chemin de support interne ?
Vérification d'identité La vérification est-elle proportionnelle, documentée et non excessive pour les données demandées ?
Recherche et récupération Tous les systèmes concernés renvoient-ils des données liées à l'ensemble d'identifiants de sujet que vous utilisez en production ?
Qualité de l'exportation L'exportation est-elle compréhensible, complète et suffisamment structurée pour être utile ?
Propagation de la suppression L'effacement atteint-il les magasins principaux, les tables dérivées, les files d'attente, les sauvegardes et les processeurs en aval ?
Gestion des exceptions Les exceptions de conservation légale ou de conservation légale sont-elles documentées avec une portée et une expiration claires ?
Ne fermez pas un test de suppression lorsque l'enregistrement de l'application disparaît. Fermez-le lorsque chaque copie en aval est soit effacée, soit comptabilisée dans une exception documentée.
La conservation et la minimisation sont là où apparaissent des copies cachées
Beaucoup de problèmes liés au GDPR résident dans la non-production. Un bon point de référence ici est la validation de remédiation. La 7ème édition du rapport de suivi de l'application du GDPR a enregistré 2 685 amendes au 1er mars 2026 totalisant environ 6,11 milliards d'euros, et un domaine souvent négligé dans les tests pratiques est l'hygiène des données non produites. Les équipes devraient vérifier que les systèmes de staging, CI et locaux ne contiennent que des données masquées, synthétiques ou anonymisées, ainsi que des vérifications sur les flux de consentement, les demandes de suppression et d'exportation, et la documentation des processus des fournisseurs, comme discuté dans cette analyse de l'application et des tests du GDPR.
Je transformerais cela en vérifications concrètes :
Assertion de minimisation Les schémas d'événements ne contiennent que les champs requis pour le but documenté.
Assertion de conservation Les travaux de TTL ou de purge suppriment les enregistrements expirés selon le calendrier, et la suppression est visible dans les journaux système.
Assertion de sauvegarde Les copies de sauvegarde soutiennent soit l'effacement ciblé, soit ont un chemin d'expiration documenté conforme à la politique.
Assertion de données synthétiques Les environnements de test, de staging et de développement local ne contiennent pas de données personnelles en direct à moins d'être strictement justifiés et contrôlés.
Les tests d'effacement pour l'IA et l'automatisation doivent être séparés
Ceci est encore sous-testé. Les listes de contrôle récentes pour l'application mettent l'accent sur la vérification que les avis de confidentialité, les flux de consentement, les évaluations d'intérêts légitimes et les demandes de suppression se propagent à travers les systèmes principaux, les sauvegardes, les processeurs tiers et les ensembles de formation d'IA, reflétant un mouvement vers des tests opérationnels continus. Voir la carte thermique de l'application du GDPR et la discussion sur la liste de contrôle.
Si votre équipe construit des flux de travail de notation, de recommandation ou de classification, ajoutez un test dédié pour les artefacts de formation et d'évaluation. Posez deux questions directes : Pouvez-vous identifier où les données d'un sujet sont entrées dans le pipeline ? Pouvez-vous les supprimer ou les supprimer dans l'utilisation future du modèle ?
Contrôles de sécurité, journalisation et tests de réponse aux incidents
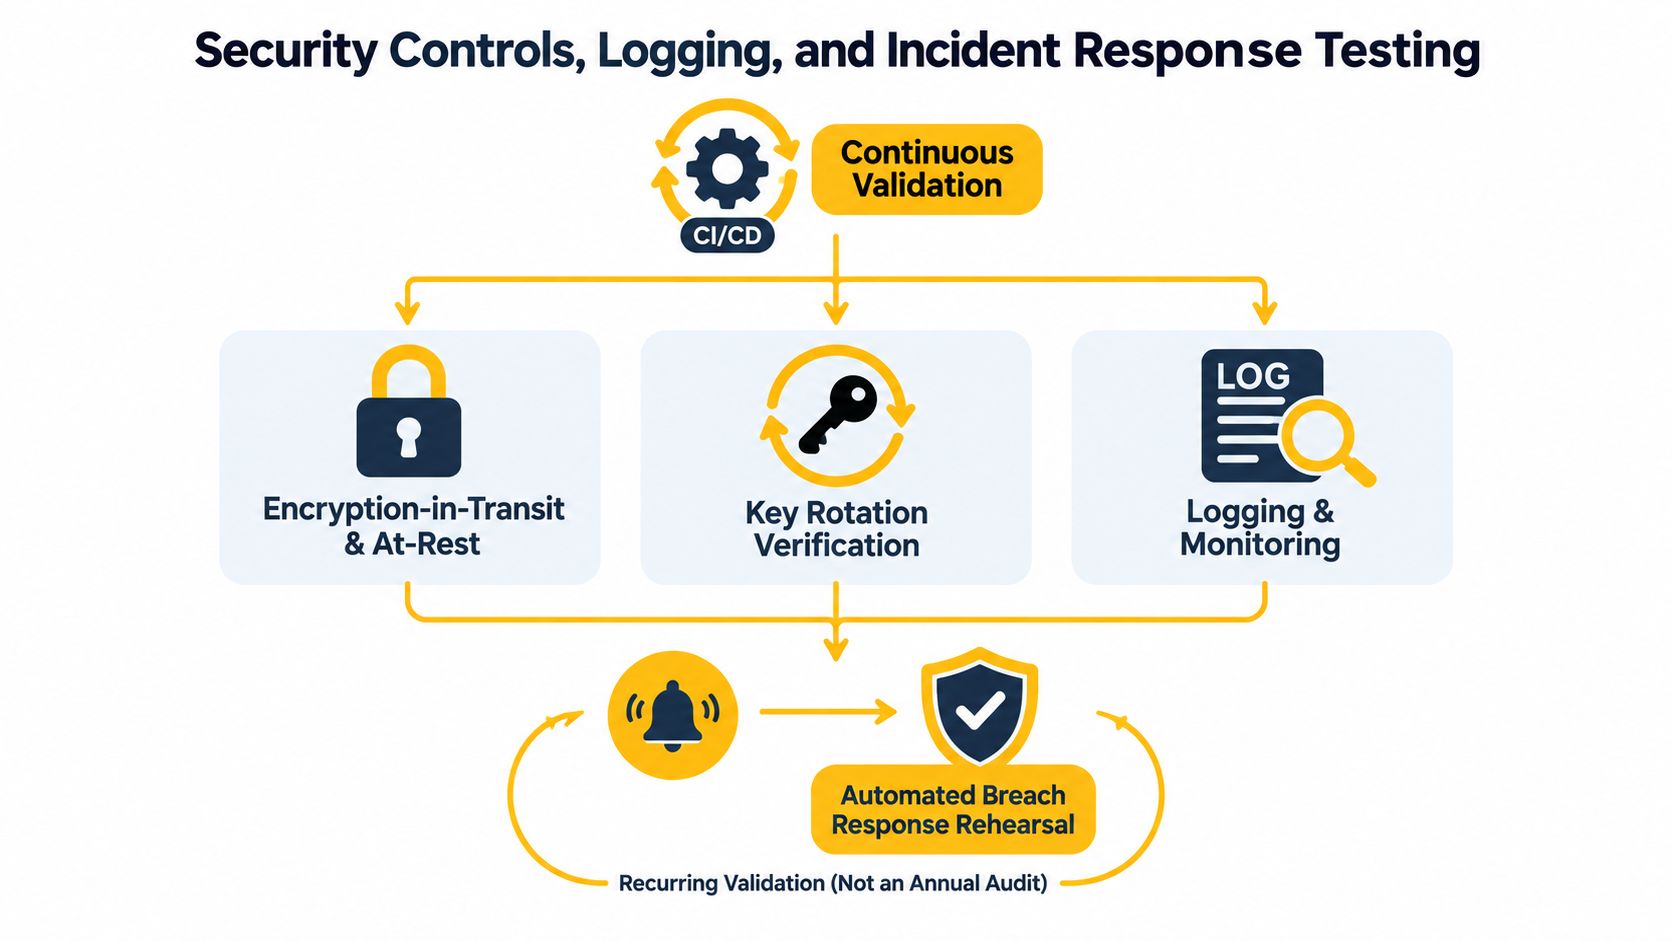
Les contrôles de confidentialité échouent lorsque les tests de sécurité sont considérés comme un événement annuel. Le GDPR britannique est exceptionnellement explicite ici. L'ICO dit que les organisations doivent avoir un processus pour tester, évaluer et évaluer régulièrement l'efficacité des mesures de sécurité. Ce cadre est important car il transforme la validation récurrente en une attente légale, pas seulement en une bonne hygiène d'ingénierie. La référence opérationnelle est le guide de l'ICO sur la sécurité des données.
Transformer l'Article 32 en assertions
Commencez par des assertions, pas des aspirations.
Chiffrement en transit Les chemins sensibles rejettent le transport non sécurisé et n'exposent que les chemins sécurisés approuvés.
Chiffrement au repos Les stockages contenant des données personnelles utilisent la protection attendue au niveau du stockage ou de l'application, et la propriété des clés est documentée.
Preuve de rotation des clés Les événements de rotation sont enregistrés, examinables, et liés à l'inventaire des actifs.
Séparation des accès Les rôles privilégiés sont plus restreints que les rôles opérationnels standards, et les comptes de test ne peuvent pas franchir la frontière.
Couverture de journalisation Les systèmes traitant des données personnelles émettent des journaux d'accès, d'actions administratives et d'échecs dans un chemin de révision central.
Ce qu'il faut collecter comme preuve
Je préfère des preuves qu'un autre ingénieur peut reproduire sans demander au testeur original ce qu'il voulait dire.
De bonnes preuves incluent :
- Instantané de configuration au moment du test
- Identité du responsable et contexte d'approbation
- Résultat du test avec résultat de réussite ou d'échec
- Ticket de remédiation lié pour les échecs
- Résultat du retest après la correction
Cette étape de retest est importante. Un examen de sécurité sans validation de remédiation est une fausse fin.
Un contrôle réussi sans preuve reproductible est plus faible qu'un contrôle échoué avec un ticket clair, un propriétaire et une date de relance.
Répéter la chronologie de la violation
Votre flux de travail de violation doit être exercé avant que vous en ayez besoin. Effectuez une répétition de table ou un exercice scripté de l'alerte à la décision de divulgation. Incluez un scénario de quasi-incident, car les équipes se concentrent souvent trop sur les compromissions confirmées et sous-testent la zone grise où les faits sont incomplets.
Une répétition pratique vérifie :
Détection La surveillance a-t-elle généré un signal exploitable ?
Triage Qui classe si des données personnelles peuvent être affectées ?
Confinement L'équipe peut-elle limiter l'accès ou arrêter une exposition supplémentaire rapidement ?
Évaluation Quelles catégories de données, systèmes et sujets peuvent être impliqués ?
Décision de notification Y a-t-il une justification documentée pour signaler ou ne pas signaler ?
Préservation des preuves Les journaux, captures d'écran et artefacts de chronologie sont-ils stockés de manière immuable ?
Si vous traitez l'activité des utilisateurs à travers des régions ou des canaux, exécutez le même scénario contre les flux de travail web, API et support. Les lacunes ne sont que rarement identiques.
Paysage des outils et configuration du réseau pour des tests conformes
Aucun outil unique ne rend un flux de travail conforme au RGPD. C'est la première règle d'achat.
Ce que les outils peuvent faire, c'est vérifier des parties étroites de la chaîne de contrôle. Vous avez toujours besoin d'un périmètre documenté, d'un examen juridique, d'une propriété et d'un retest. Pour les équipes gérant la publication sociale, les vérifications publicitaires, l'intelligence de marché, la surveillance SEO ou le QA géo-dépendant, la couche réseau est également importante car la localisation affecte ce que l'utilisateur voit et quelles données sont traitées.
Catégories d'outils pour les tests de conformité au RGPD
| Catégorie d'outil | Ce qu'il vérifie | Limitation clé |
|---|---|---|
| Scanners de découverte de données | Où les données personnelles apparaissent à travers les bases de données, le stockage et les journaux | Ils peuvent manquer de contexte, de base légale et d'utilisation commerciale en aval |
| Outils de flux de travail de consentement | État de la bannière, capture des préférences et signaux de propagation | Ils ne prouvent pas que chaque processeur en aval a respecté l'état |
| Systèmes de flux de travail DSAR | Intégration, routage, approbation et suivi des cas | Ils peuvent cacher des lacunes de récupération dans les systèmes sources |
| Générateurs de données synthétiques | Exposition réduite dans des environnements non productifs | Ils ne corrigent pas à eux seuls les mauvais contrôles de conservation ou d'accès |
| Piles de journalisation centralisées | Auditabilité des accès, des changements et des événements d'incidents | La couverture n'est aussi bonne que les intégrations qui les alimentent |
Les choix de réseau affectent la qualité des tests
Si vous devez valider des bannières spécifiques à une région, un rendu publicitaire localisé, un routage basé sur le pays ou des protections de compte qui varient selon le réseau utilisateur, votre trafic de test doit ressembler à un trafic utilisateur légitime de la géographie concernée.
C'est là que les proxies de datacenter, résidentiels et mobiles diffèrent :
Proxies de datacenter proviennent de fournisseurs d'hébergement. Ils sont utiles pour l'automatisation stable, mais ils sont souvent plus faciles à identifier pour les systèmes cibles comme un trafic non consommateur.
Proxies résidentiels passent par l'espace IP des ménages. Ils peuvent mieux correspondre aux modèles de navigation ordinaires pour les vérifications régionales.
Proxies mobiles 4G et 5G passent par les réseaux des opérateurs. Ils sont souvent plus difficiles à lier à un utilisateur spécifique car le NAT de niveau opérateur permet à de nombreux abonnés de partager un pool IPv4 limité, ce qui rend le trafic mobile plus similaire à un trafic consommateur normal pour les systèmes de réputation. Une vérification pratique consiste à vérifier le ASN de sortie, ou numéro de système autonome, car une véritable sortie mobile devrait se résoudre à un ASN d'opérateur sans fil plutôt qu'à un ASN d'entreprise d'hébergement. Ce comportement est expliqué dans cette discussion sur le CGNAT et le partage d'IP mobile.
Pour le QA et les tests de conformité, cela ne signifie pas « utiliser mobile partout ». Cela signifie utiliser le type de réseau qui correspond au flux que vous validez, puis le documenter.
Rotation, persistance et choix de protocole
Votre enregistrement de test devrait inclure les mécaniques réseau :
- Rotation IP pour des sessions indépendantes répétées
- Sessions persistantes lorsque la continuité est importante à travers des flux de travail multi-étapes
- Géographie de sortie jusqu'au pays ou à la région utilisée
- Choix de protocole, généralement HTTP/HTTPS ou SOCKS5
Ces détails affectent le comportement observé. SOCKS5 est couramment utilisé pour l'automatisation non basée sur un navigateur, et certaines configurations de proxy mettent en œuvre le ciblage géographique via des paramètres de nom d'utilisateur ou de point de terminaison plutôt que par le protocole lui-même. C'est une commodité de test utile, mais cela signifie également que la reproductibilité dépend de la journalisation de ces paramètres avec soin, comme décrit dans cette documentation sur SOCKS5 et le ciblage géographique.
Si vous avez besoin d'une option mobile documentée pour un QA sensible à la géographie, un exemple est les conseils de configuration de l'environnement de test associés à un fournisseur tel qu'Evoproxy, qui offre une connectivité mobile 4G française pour une validation précise par région. Utilisé correctement, c'est juste un choix d'infrastructure parmi plusieurs. La partie conformité est la traçabilité des preuves que vous conservez autour de chaque exécution.
Cadence de reporting, modèles de preuves et scripts d'exemple
Les tests sont pris au sérieux lorsque la cadence de reporting est ennuyeuse, cohérente et difficile à contester.
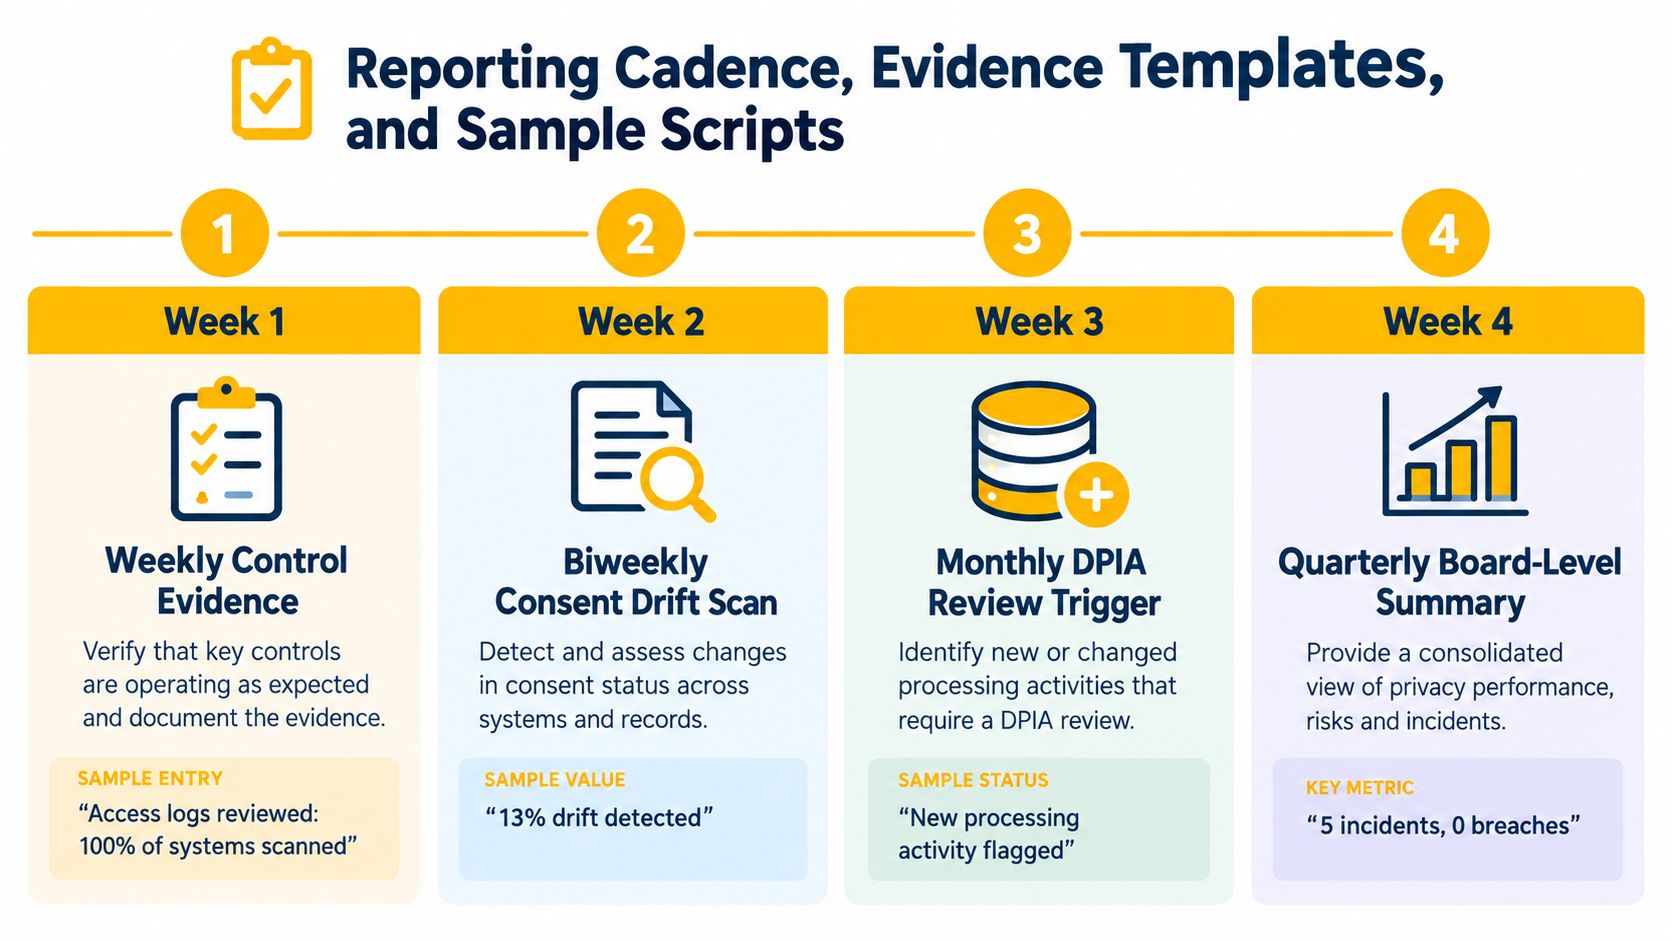
Une cadence que les équipes peuvent réellement maintenir
Utilisez un cycle court qui produit des preuves prêtes pour l'audit sans transformer la vie privée en un projet secondaire que personne ne peut soutenir.
Revue hebdomadaire des preuves Confirmez que les tests de contrôle programmés ont été exécutés, inspectez les échecs et assignez des propriétaires de remédiation.
Revue mensuelle des traitements Vérifiez si de nouveaux flux de travail, fournisseurs, régions ou utilisations de l'IA ont modifié la position de la DPIA.
Résumé exécutif trimestriel Résumez la santé des contrôles, les risques non résolus, les thèmes d'échecs récurrents et les remédiations en retard.
Modèle de preuve minimal
Un enregistrement pratique a généralement besoin de ces champs :
| Champ | Pourquoi c'est important |
|---|---|
| Propriétaire du contrôle | Quelqu'un doit répondre des répétitions et des remédiations |
| Portée du test | Définit les systèmes, les processeurs et les identifiants concernés |
| Exécution de l'assertion | Indique exactement ce qui a été testé |
| Résultat | Réussite, échec ou bloqué |
| Chemin de preuve | Pointe vers les journaux, les captures d'écran, les enregistrements ou les exports |
| Propriétaire de la remédiation | Nomme celui qui résout le problème |
| Date de retest | Empêche qu'un "problème connu" devienne permanent |
Exemple d'enregistrement de violation de conservation
Voici le style de sortie de script que je voudrais d'un balayage de conservation échoué :
Violation de la politique de conservation. La requête source ciblait des pièces jointes de support client expirées dépassant le seuil de conservation documenté. Le résultat attendu était zéro enregistrements actifs. Le résultat réel a retourné des enregistrements toujours présents dans le stockage d'objets et indexés dans la recherche. La gravité est marquée comme élevée car l'automatisation de la suppression a été exécutée mais n'a pas purgé les métadonnées dérivées. Le ticket de remédiation lié comprend le chemin de stockage, l'horodatage d'exécution, l'identité du coureur et l'instantané de configuration utilisé pour le test.
La clé est la reproductibilité. Chaque artefact doit porter un horodatage, l'identité du coureur ou du compte de service, la version de configuration et un chemin de stockage immuable. Conservez les artefacts de test suffisamment longtemps pour soutenir la responsabilité, mais appliquez également des règles de conservation aux artefacts eux-mêmes.
Liste de contrôle des tests récurrents et prochaines étapes
La liste de contrôle récurrente est simple. La discipline ne l'est pas.
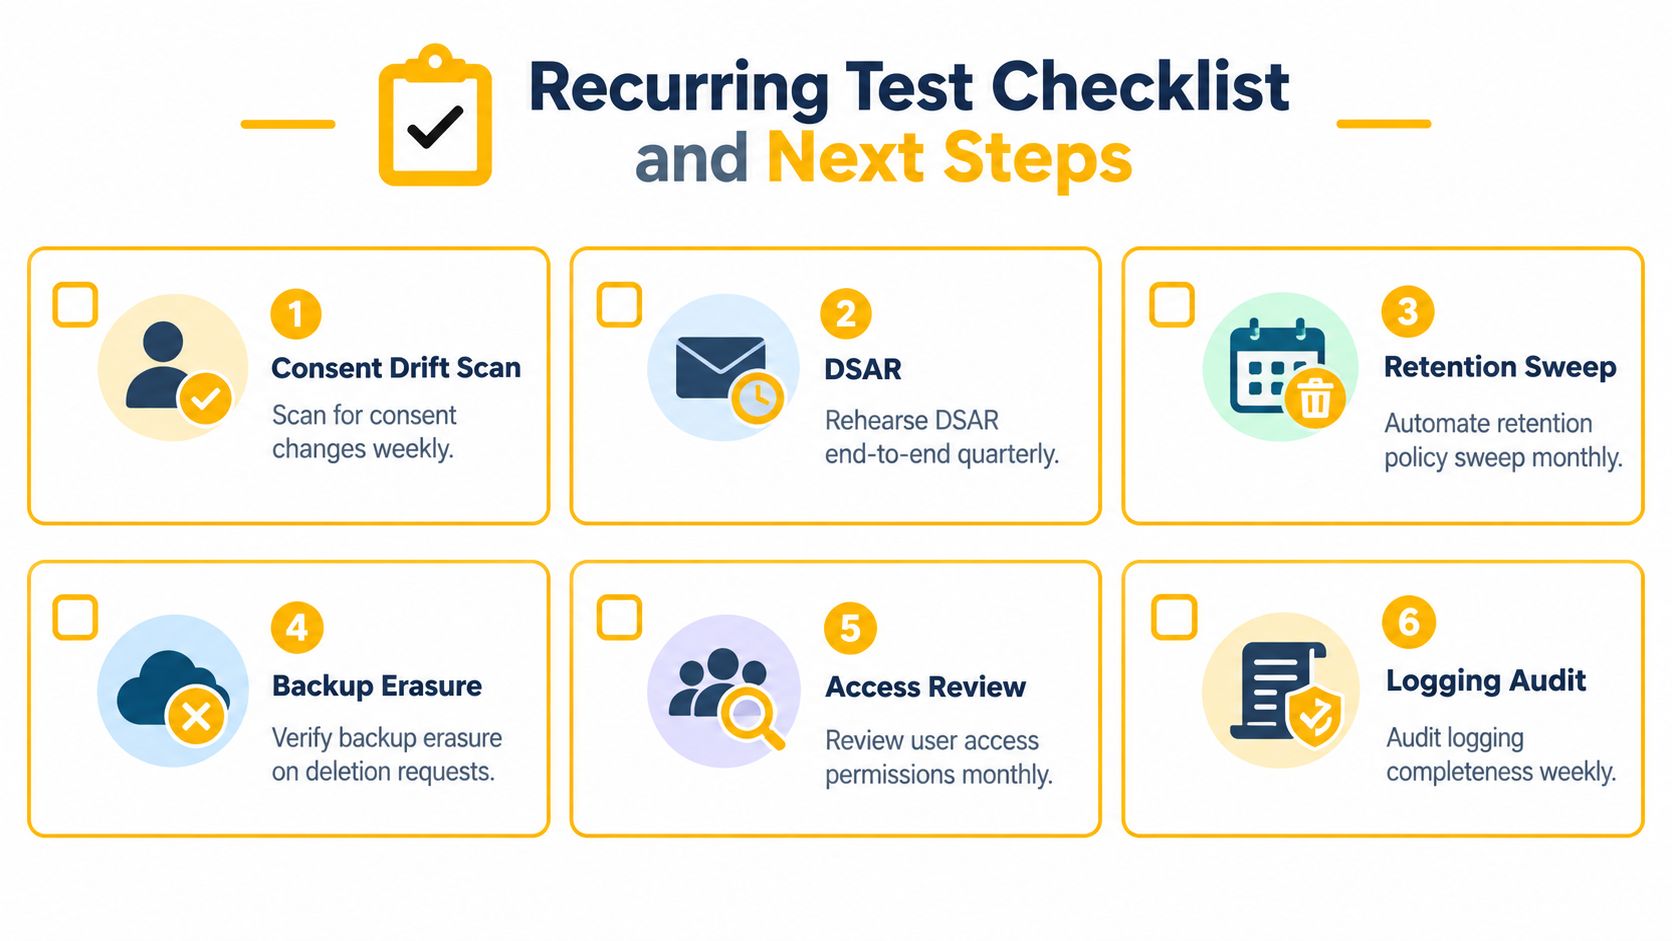
Utilisez un calendrier fixe qui couvre :
- Scans hebdomadaires de dérive de consentement à travers les bannières, les états SDK et les processeurs en aval
- Répétitions trimestrielles de DSAR de l'entrée à l'exportation ou à l'effacement
- Balayages mensuels de conservation pour les magasins principaux, les journaux et le stockage d'objets
- Vérifications d'effacement des sauvegardes chaque fois que les chemins de suppression ou l'architecture de stockage changent
- Revue d'accès mensuelle pour les rôles privilégiés et de support
- Vérifications hebdomadaires de l'intégrité des journaux pour confirmer que la couverture d'audit est complète
Pour les flux dépendants de la géographie, enregistrez le chemin réseau utilisé pour tester les bannières localisées, le routage transfrontalier ou le traitement des demandes spécifiques à la région. Cet enregistrement doit inclure le comportement de session, la géographie et les choix de protocole, aux côtés de votre référence des exigences de conformité plus large. Si votre travail dépend d'un contrôle qualité précis en fonction de la localisation, les proxies mobiles 4G peuvent être une option pratique car ils ressemblent mieux au routage ordinaire des consommateurs qu'aux sorties de centre de données, surtout lorsque vous avez besoin de tests répétables sans rompre la chaîne d'audit.
Si votre équipe a besoin de tests géo-précis pour des bannières de consentement localisées, des vérifications publicitaires régionales ou des flux d'utilisateurs transfrontaliers, Evoproxy propose une infrastructure mobile 4G qui convient à ces scénarios de contrôle qualité sensibles à la conformité. C'est utile lorsque vous avez besoin d'un contrôle de session documenté, de sorties basées sur des opérateurs réalistes et de tests de région reproductibles sans traiter la couche réseau comme une réflexion après coup. Vous pouvez voir les options de configuration et évaluer leur adéquation à votre flux de travail sur Evoproxy.


