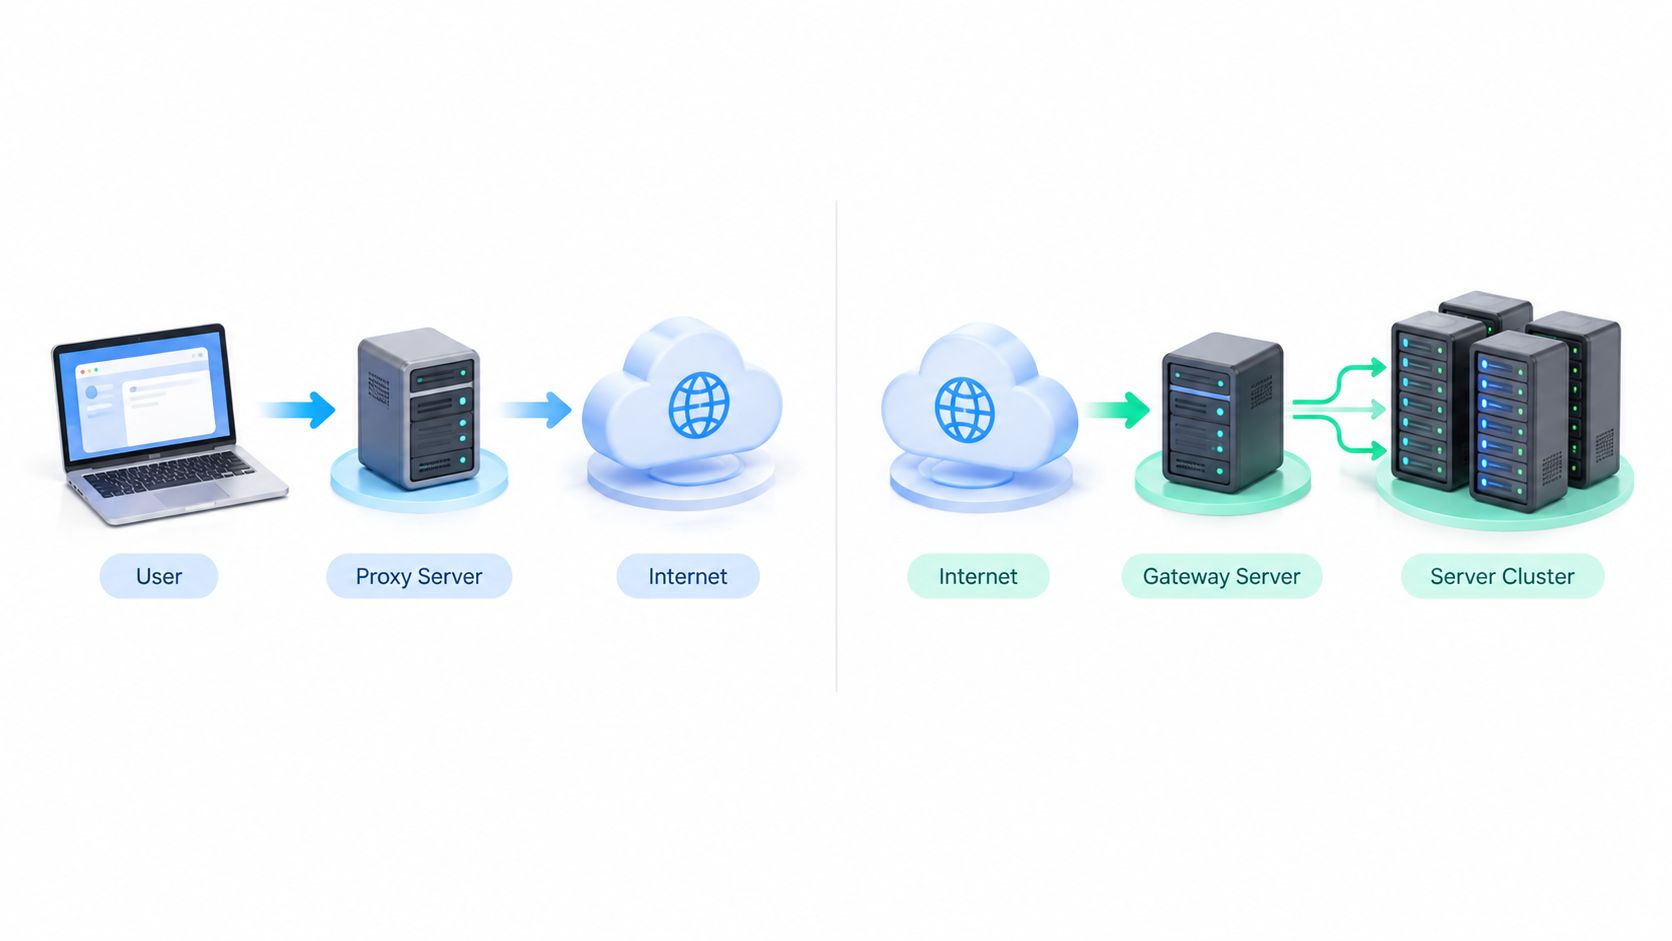
Vos comptes de médias sociaux sont signalés même si le contenu et le processus de connexion semblent normaux. En même temps, un développeur de votre équipe observe un ralentissement du site produit alors que les visiteurs arrivent, tandis qu'un rapport de vérification des annonces montre un résultat différent de ce qu'un utilisateur réel voit. Tous ces problèmes peuvent impliquer des proxies, mais ils n'impliquent pas le même genre.
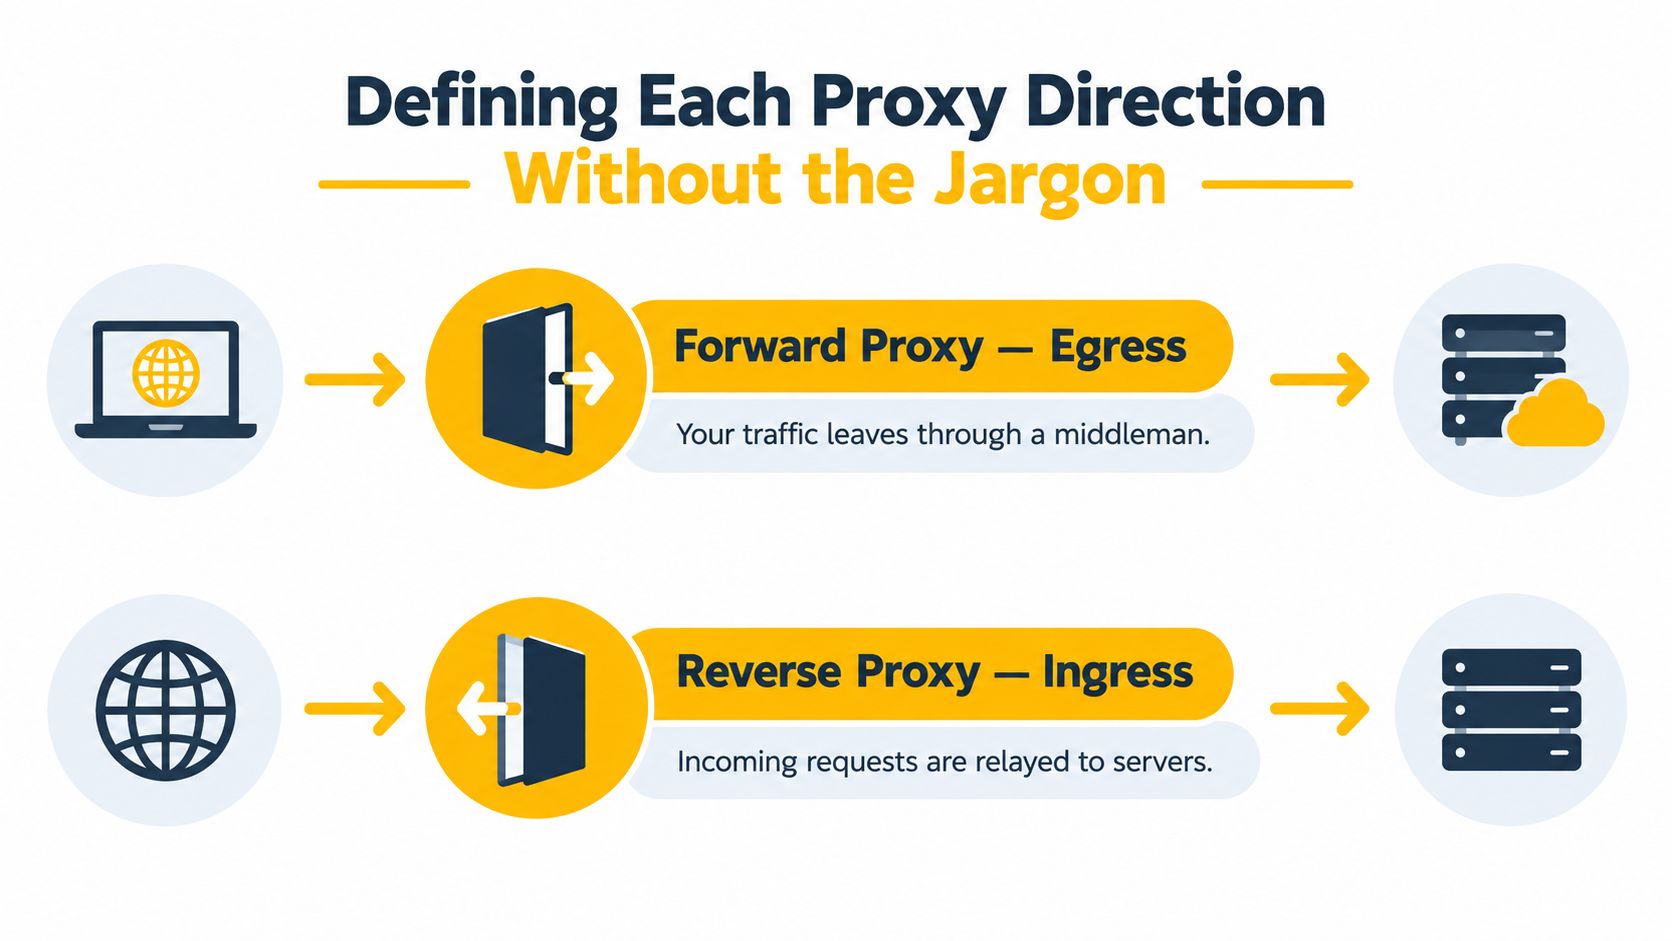
La différence entre un proxy direct et un proxy inverse réside dans le trafic que l'intermédiaire représente. Un proxy direct représente le client et gère les demandes sortantes. Un proxy inverse représente le service et gère les demandes entrantes. La distinction semble simple, mais elle détermine qui choisit la destination, qui contrôle l'identité réseau visible et quels indicateurs opérationnels sont importants.
Une règle utile est la suivante : utilisez un proxy direct lorsque vous contrôlez le client et devez contrôler l'égresse. Utilisez un proxy inverse lorsque vous contrôlez le service et devez contrôler l'entrée. Les sections ci-dessous appliquent cette règle aux opérations sur les médias sociaux, à la vérification des annonces, à la recherche, à l'assurance qualité et à l'infrastructure web.
Pourquoi ces deux directions de proxy perturbent les équipes intelligentes
La direction du proxy est souvent négligée jusqu'à ce que quelque chose se comporte de manière étrange. Un responsable des médias sociaux peut avoir besoin de plusieurs espaces de travail de compte conformes pour apparaître dans des contextes réseau appropriés. Un spécialiste de la vérification des annonces peut voir une campagne d'une région mais pas d'une autre. Un développeur peut placer une passerelle devant une application et l'appeler un « proxy » sans décider si la passerelle représente des visiteurs ou des serveurs.
Ce dernier point cause beaucoup de confusion. Les deux types de proxy se situent entre deux parties, relaient des demandes et peuvent affecter ce que chaque côté voit. Le diagramme semble similaire, mais la limite de confiance et le décideur sont opposés.
Commencez par la décision de destination
Dans un design de proxy direct, le client choisit le serveur d'origine. Votre navigateur, scraper, script de test ou client d'automatisation décide quel site web ou API contacter, puis envoie la demande par l'intermédiaire. Dans un design de proxy inverse, le proxy ou le propriétaire du service choisit le serveur d'origine après avoir reçu une demande pour un service public, comme expliqué dans cette explication architecturale des proxies directs et inverses.
Cette distinction se traduit directement dans le travail quotidien :
- Si votre équipe décide quel site web externe atteindre, vous pensez à un proxy direct.
- Si votre équipe décide quel backend doit gérer un visiteur entrant, vous pensez à un proxy inverse.
Un proxy mobile utilisé par un client de recherche sortante est donc un cas d'utilisation de proxy direct. Une passerelle de site web distribuant des visiteurs à travers des serveurs d'application est un cas d'utilisation de proxy inverse.
Règle pratique : Demandez à qui appartient l'identité que représente le proxy. S'il représente votre application ou appareil, pensez direct. S'il représente votre site web ou service backend, pensez inverse.
Cet article est un outil de décision, pas un exercice de nomination. Une fois que vous avez identifié le côté qui a besoin de contrôle de politique, la direction de proxy appropriée devient généralement claire.
Définir chaque direction de proxy sans le jargon
Un spécialiste du marketing de croissance vérifie le site d'un concurrent via une connexion mobile. Le navigateur envoie la demande à un proxy direct, qui contacte ensuite le site web choisi. Le site web voit généralement l'adresse du proxy, pas la connexion du bureau de l'équipe. Le client décide de la destination, tandis que le proxy gère le chemin sortant.
Ce modèle convient à la navigation des employés, au scraping, à la vérification des annonces et aux tests de localisation. Une entreprise peut filtrer les destinations, appliquer des règles d'accès sortantes, enregistrer des demandes ou fournir une sortie Internet partagée. Un responsable des médias sociaux ou une application de recherche peut sélectionner un proxy mobile 4G afin qu'un site externe reçoive une adresse associée à un opérateur. Le proxy représente le navigateur, l'appareil ou l'application demandeur.
Un proxy inverse fait le choix opérationnel opposé. Un visiteur se connecte à une adresse de site web public, et le proxy inverse décide quel serveur d'origine doit gérer la demande. Le visiteur ne sélectionne ni ne voit ce backend. Le proxy représente le site web et son infrastructure.
Cette configuration permet à un site de distribuer des visiteurs à travers des serveurs d'application, de terminer le TLS, de mettre en cache les réponses, d'appliquer l'authentification ou de limiter l'exposition directe de l'origine. Un vérificateur d'annonces utilisant un proxy direct mobile choisit où aller et comment la demande sort. Un proxy inverse devant le site web vérifié reçoit cette visite et choisit comment le service répond. La distinction est résumée dans le guide de Mozilla sur les serveurs proxy et le tunneling.
Les protocoles ne déterminent pas la direction
HTTP, HTTPS et SOCKS décrivent la méthode de transport, pas la responsabilité du proxy. La méthode HTTP CONNECT peut demander à un proxy direct de créer un tunnel pour le trafic chiffré, sans exiger que le proxy inspecte les données de l'application à l'intérieur.
Les paramètres du navigateur peuvent distinguer HTTP, HTTPS sur TLS, SOCKS5 et SOCKS4, comme le montre la référence de configuration des proxies de Mozilla. SOCKS5 fonctionne à un niveau de connexion plus large et peut convenir aux applications nécessitant un support TCP plus large. Changer de protocole ne change pas la direction. Si le client choisit toujours la destination externe, le proxy reste direct.
Comparaison côte à côte des proxies directs et inverses
La comparaison la plus fiable utilise cinq questions : où se situe le proxy, dans quelle direction circule le trafic, qui le configure, quel travail effectue-t-il et à quoi ressemble un déploiement normal ?
Un proxy direct se situe du côté client de la relation. Le client a délibérément routé les demandes à travers lui, soit par le biais des paramètres de l'application, de la politique de l'appareil ou de l'application du réseau. La destination voit la source apparente du proxy, ce qui rend possible la politique sortante, l'audit, le filtrage et la gestion de l'égresse.
Un proxy inverse se situe du côté service. Les clients atteignent un point de terminaison public, et le proxy transfère les demandes à un ou plusieurs serveurs d'origine. Le proxy peut prendre des décisions de routage, gérer le TLS, mettre en mémoire tampon les demandes, mettre en cache le contenu et restreindre l'exposition directe de l'infrastructure backend.
| Critère | Proxy direct | Proxy inverse |
|---|---|---|
| Représente | Le client demandeur, l'utilisateur, l'application ou l'appareil | Le service de destination et ses serveurs d'origine |
| Position réseau | Entre les clients et les destinations externes | Devant un ou plusieurs serveurs d'origine |
| Direction du trafic | Trafic sortant des clients | Trafic entrant vers les services |
| Qui le configure | Le client, l'équipe informatique, le propriétaire de l'application ou l'administrateur réseau | Le propriétaire du site web, de la plateforme ou de l'infrastructure |
| Travaux principaux | Contrôle de l'égresse, filtrage, audit, masquage de source et politique sortante | Équilibrage de charge, terminaison TLS, mise en cache, authentification et protection de l'origine |
| Identité visible | La destination voit généralement le proxy au lieu de la source du client | Le client voit le proxy comme le point d'entrée du service public |
| Exemple typique | Un client de recherche atteignant des sites externes via un réseau mobile | Une passerelle web distribuant des visiteurs à travers des serveurs d'application |
Les indicateurs changent également avec la direction. Les proxies directs sont évalués par l'accès à la destination, la couverture de la politique, la fiabilité de la connexion, la qualité du réseau source et le comportement côté client. Les proxies inverses sont évalués par le débit des demandes, la latence, l'utilisation du backend, les limites de connexion, le comportement de mise en cache et la gestion des échecs.
La discussion sur la sécurité des applications de Cloudflare illustre pourquoi les deux modèles ne devraient pas être mesurés comme s'ils étaient des versions concurrentes du même produit. Un proxy direct contrôle principalement le trafic sortant des clients. Un proxy inverse contrôle le trafic entrant vers les services. Ils résolvent différents problèmes opérationnels et se développent selon différentes contraintes.
Flux de travail réels qui nécessitent chaque direction de proxy
Une direction de proxy devient plus facile à choisir lorsque vous commencez par le travail plutôt que par le diagramme réseau. Demandez si votre équipe atteint un service externe ou publie un service pour que d'autres personnes puissent y accéder.
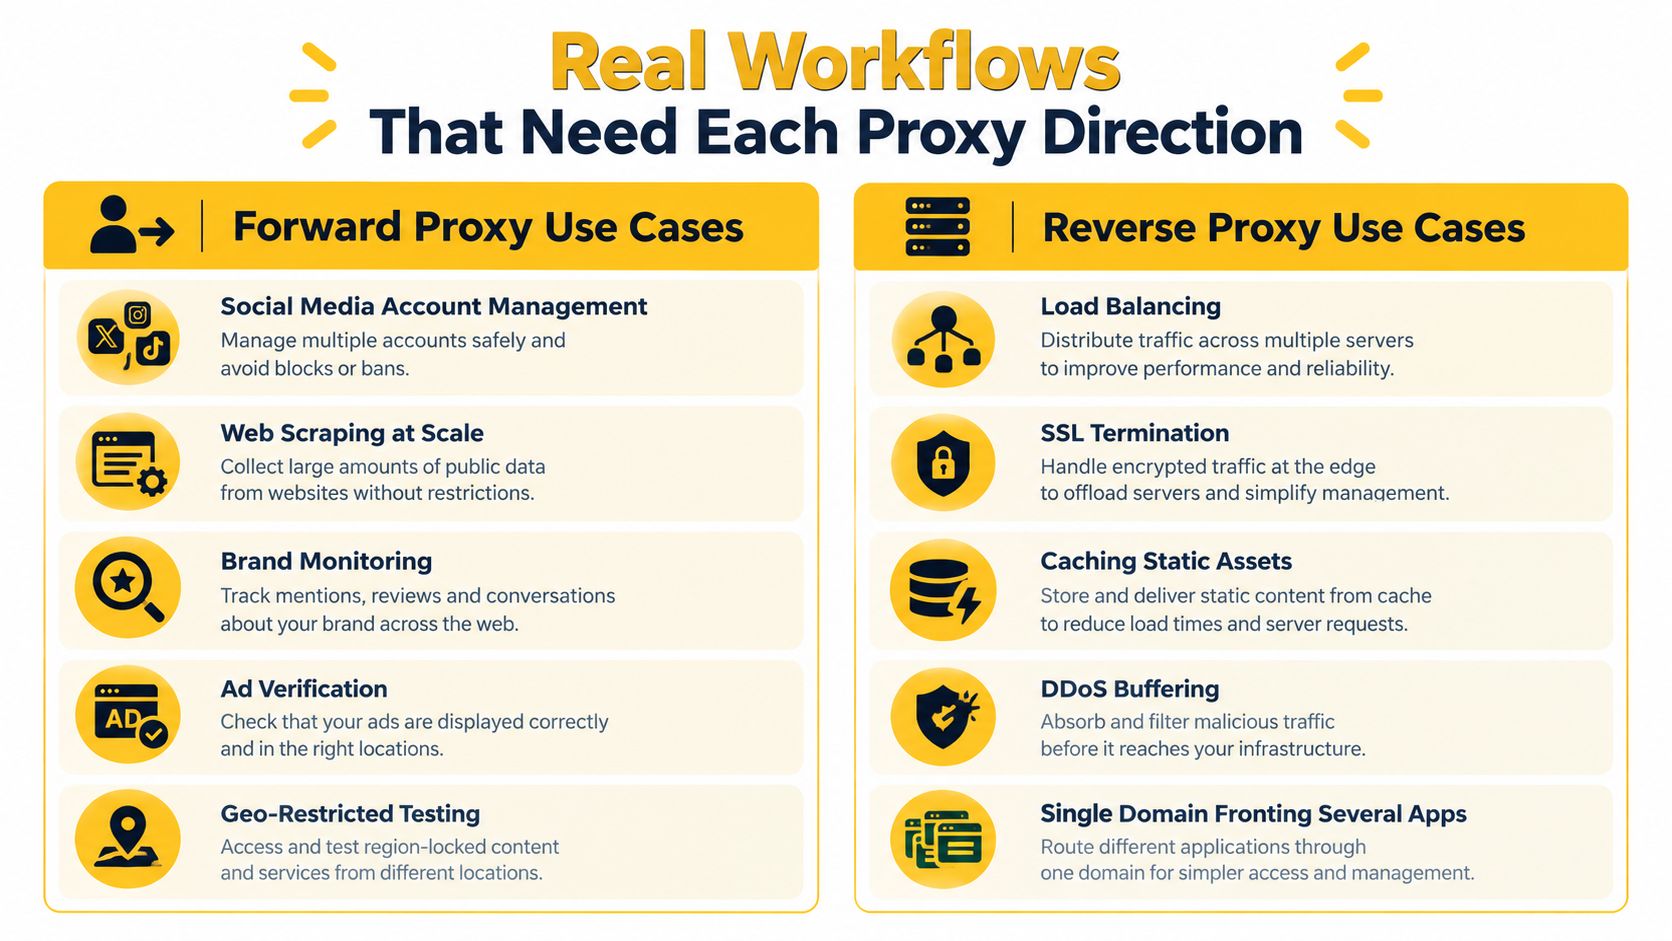
Cinq flux de travail sortants
La gestion des médias sociaux multi-comptes nécessite généralement un proxy direct. Chaque espace de travail de compte conforme ou client d'automatisation approuvé établit des connexions sortantes vers une plateforme externe. Un proxy inverse devant votre propre tableau de bord pourrait améliorer votre application interne, mais cela ne changera pas la façon dont les requêtes sortantes de ce tableau de bord apparaissent sur la plateforme de destination.
La vérification des annonces utilise également un proxy direct. Le vérificateur doit demander une page de destination, un résultat d'annonce ou une expérience de campagne depuis un contexte de localisation et de réseau pertinent pour le test. L'objectif est d'observer ce qu'un service externe renvoie à un client, et non de distribuer des visiteurs sur vos propres serveurs.
La surveillance des prix et du SEO suit le même schéma. Un client de recherche envoie des requêtes vers des sites externes, puis enregistre les prix, les classements, les extraits ou la disponibilité à des fins de surveillance autorisées. Utilisez des contrôles de taux, respectez les politiques d'accès et gardez la portée de la collecte proportionnelle à la question commerciale.
La protection de la marque peut impliquer un proxy direct lorsque l'équipe vérifie des listes publiques, des pages d'usurpation d'identité ou des vitrines régionales depuis différents emplacements. Le proxy change le chemin sortant pour le client de surveillance. Il ne donne pas la permission d'accéder à du matériel restreint ou de contourner les règles d'un site.
Les tests QA dépendants de la géographie constituent un autre flux de travail de proxy direct. Un testeur peut valider les redirections régionales, le contenu localisé, la présentation des devises ou un processus de paiement sensible à la localisation depuis un environnement de test approprié. Un proxy inverse aiderait le propriétaire de l'application à diriger les testeurs entrants, mais cela ne ferait pas en sorte que la requête du testeur provienne du contexte de réseau externe requis.
Cinq flux de travail d'infrastructure entrants
Les proxies inverses servent le côté opposé de ces tâches :
- Équilibrage de charge envoie des visiteurs vers des serveurs d'application appropriés.
- Terminaison TLS centralise la gestion des connexions chiffrées à la périphérie publique.
- Mise en cache sert du contenu réutilisable sans impliquer l'origine pour chaque requête.
- Buffering de trafic aide à protéger les backends des vitesses inégales des clients et de la demande soudaine.
- Front de l'application expose un domaine public tout en dirigeant les requêtes vers plusieurs services internes.
Si votre équipe construit un flux de travail sortant, un service de proxy API appartient à la discussion sur le proxy direct. Si votre équipe possède l'application de destination, l'architecture de proxy inverse est le modèle pertinent.
Proxies résidentiels mobiles et de datacenter en tant que saveurs de proxy direct
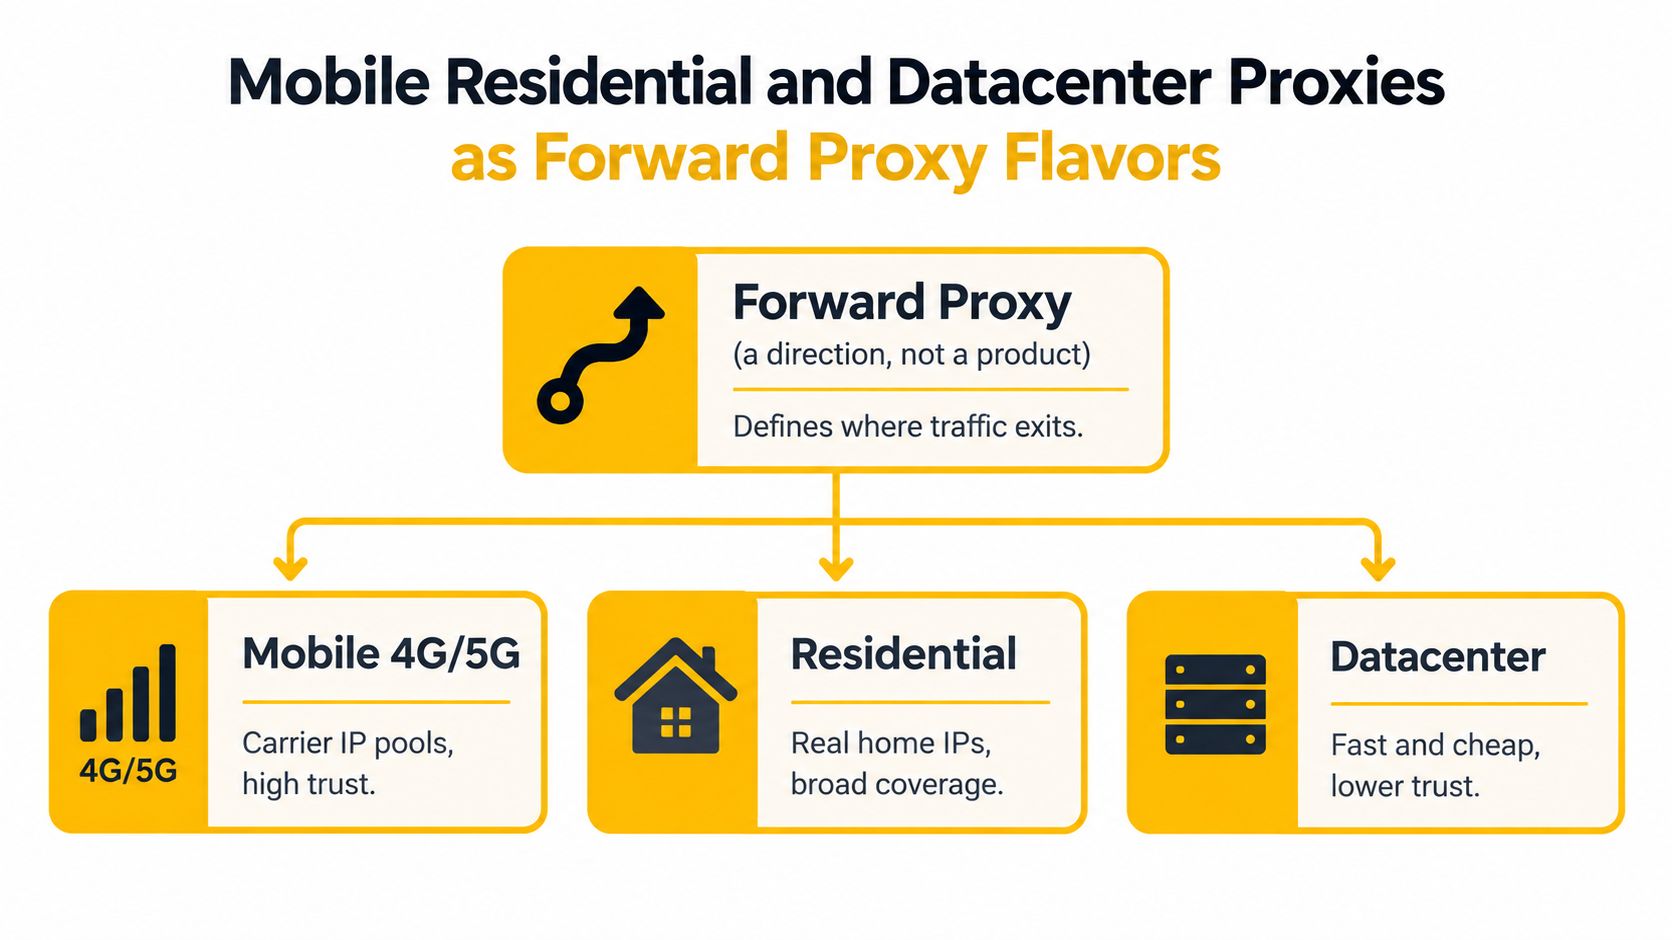
Un proxy direct est une direction, pas une catégorie de produit. Une fois que vous avez décidé que le client a besoin d'un trafic sortant contrôlé, vous devez encore choisir le réseau derrière l'adresse de sortie. Les proxies mobiles 4G/5G, résidentiels et de datacenter sont tous des saveurs de proxy direct lorsque le client les utilise pour atteindre des destinations externes.
Ce que la destination peut inférer
Un proxy de datacenter appartient généralement à un ASN de fournisseur d'hébergement ou de cloud. Un ASN, ou Numéro de Système Autonome, identifie un réseau fonctionnant sous une politique de routage commune. Ce signal de propriété du réseau peut influencer le scoring de fraude, les contrôles de taux, les résultats de vérification des annonces et la QA dépendante de la géographie. La documentation de la base de données de RIPE NCC explique que les informations IP et ASN peuvent soutenir la géolocalisation IP, bien qu'un ASN ne soit pas une déclaration précise de l'endroit où un utilisateur est physiquement situé.
Les proxies résidentiels sont plus étroitement associés aux réseaux de services Internet domestiques. Les proxies mobiles sont associés aux réseaux de télécommunications et à l'infrastructure des opérateurs. Cette différence est importante car une adresse mobile peut ressembler à un trafic d'abonné ordinaire plutôt qu'à une connexion de serveur hébergé dans le cloud, ce qui peut rendre les IP mobiles 4G plus difficiles à identifier et à bloquer pour les destinations. "Plus difficile" n'est pas synonyme d'invisible, et la qualité du réseau, le comportement, l'authentification et la conformité restent importants.
NAT de niveau opérateur, ou CGN, ajoute un autre détail important. La discussion de l'IETF sur le NAT de fournisseur et le partage d'adresses explique qu'un fournisseur peut attribuer des adresses d'abonné privées tout en partageant un plus petit pool d'adresses IPv4 publiques entre plusieurs abonnés. L'IP publique d'un réseau mobile peut donc représenter de nombreux appareils non liés. Une IP seule n'est pas un signal d'identité complet, et l'attribution peut être plus difficile que pour une adresse de datacenter hébergée dans le cloud.
Rotation contre continuité
La rotation IP change l'adresse de sortie selon un calendrier ou un déclencheur à la demande. Cela peut aider un flux de travail de recherche ou de QA légitime à tester plusieurs contextes réseau, mais la rotation doit correspondre à l'application et aux règles d'accès du site. Changer constamment d'identité pendant un flux de travail authentifié peut créer plus d'anomalies que cela n'en résout.
Une session collante maintient le même chemin de sortie pour une session ou une tâche définie. Cela est important lorsque la connexion, le panier, l'état du navigateur ou un test en plusieurs étapes doivent rester cohérents. Choisissez la rotation pour des observations séparées et les sessions collantes pour la continuité.
Pour la recherche régionale, vérifiez à la fois la géographie apparente et l'ASN. Une adresse changeante à l'intérieur du même ASN d'opérateur peut faire tourner l'IP sans changer la catégorie de réseau visible. Passer à un ASN de cloud change un signal de classification plus évident. Evoproxy décrit l'utilisation des proxies mobiles et la connectivité basée sur les opérateurs dans son guide des proxies mobiles, mais tout fournisseur doit être évalué par rapport à votre flux de travail spécifique, vos autorisations et vos exigences de journalisation.
Pourquoi les proxies inverses ne sont pas automatiquement sécurisés
Appeler un proxy inverse "sécurité" et un proxy direct "vie privée" est trop vague pour guider une décision de production. Un proxy inverse peut cacher la topologie backend, terminer TLS, appliquer l'authentification, mettre en cache du contenu et filtrer des requêtes. Il devient également partie de la frontière de confiance de l'application lorsqu'il réécrit des en-têtes, transmet des informations d'identité à l'origine ou remet des résultats d'authentification aux services backend.
Cela crée une responsabilité, pas une protection automatique. Le propriétaire du service doit authentifier la connexion proxy-à-origine, valider les en-têtes transférés, restreindre l'accès direct à l'origine aux réseaux de proxy de confiance et surveiller le comportement à la fois du proxy et du backend. Un proxy inverse ne doit pas être traité comme un pare-feu complet, un point renforcé par les conseils de sécurité des proxies sur les limites des deux directions.
Le côté proxy direct a aussi des lacunes
Un proxy direct ne gouverne que les clients qui l'utilisent. Un appareil non géré peut se connecter directement. Une application peut ignorer les paramètres de proxy système. D'autres canaux peuvent contourner le chemin prévu. Le proxy ne protège pas non plus automatiquement le client contre les logiciels malveillants, les fuites de données ou un intermédiaire compromis.
Considérez le proxy comme une couche dans un système de contrôle plus large :
- Authentifier le trafic proxy-vers-origine afin qu'un backend puisse distinguer les demandes de passerelle de confiance.
- Valider les en-têtes d'identité transférés au lieu d'accepter aveuglément les valeurs fournies par le client.
- Restreindre l'exposition de l'origine afin que l'internet public ne puisse pas contourner le proxy inverse.
- Consigner soigneusement les deux identités, y compris le contexte du client d'origine et le contexte de connexion généré par le proxy.
- Surveiller la latence et les échecs au niveau du proxy et de l'origine plutôt que de supposer qu'une connexion réussie signifie un service sain.
Un proxy avant nécessite également de la confiance. Il peut voir ou influencer le trafic en fonction de sa configuration et des protocoles qu'il gère, donc les identifiants, les données sensibles et les autorisations d'accès nécessitent une protection appropriée. Pour les équipes mettant en œuvre un transfert chiffré, un serveur proxy avec SSL peut faire partie de la conception, mais cela ne supprime pas le besoin de sécurité des points de terminaison ou de contrôles d'autorisation.
Principe de sécurité : Choisissez la direction du proxy en fonction du côté qui nécessite un contrôle de politique. Utilisez des proxies avant pour la gouvernance des sorties et des proxies inverses pour la gestion des entrées et la protection de l'origine.
Exemples de configuration minimale pour les deux directions
La configuration doit rendre la direction visible. Un client avant envoie des demandes sortantes à un intermédiaire. Une passerelle inverse reçoit des demandes publiques, puis les achemine vers une application interne.
Pour un gestionnaire de médias sociaux ou un vérificateur de publicités utilisant un point de terminaison mobile 4G, le client sélectionne la destination et fournit les paramètres du proxy :
import requests

proxies = {
    "http": "http://USER:PASSWORD@MOBILE_PROXY_ENDPOINT:PORT",
    "https": "http://USER:PASSWORD@MOBILE_PROXY_ENDPOINT:PORT",
}

response = requests.get(
    "https://example.test/region-check",
    proxies=proxies,
    timeout=30,
)
L'objet proxies applique l'intermédiaire aux demandes HTTP et HTTPS sortantes. Le client choisit toujours la destination. Stockez les identifiants et les points de terminaison dans une configuration sécurisée plutôt que dans le contrôle de source, et testez uniquement les cibles autorisées.
Un opérateur de site web configure la direction inverse à la passerelle :
upstream application_pool {
    server app_a;
    server app_b;
}

server {
    listen 443 ssl;
    server_name example.test;

    location / {
        proxy_pass http://application_pool;
        proxy_set_header Host $host;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
    }
}
Ici, upstream énumère les choix de backend. proxy_pass achemine les demandes entrantes, tandis que proxy_set_header Host préserve l'hôte demandé pour le routage de l'application. L'en-tête forwarded-for porte le contexte du client, donc l'application ne devrait lui faire confiance que par un chemin proxy approuvé.
Le protocole et la direction sont des décisions séparées. Un navigateur ou une bibliothèque de requêtes peut utiliser HTTP, HTTPS sur TLS, SOCKS5 ou SOCKS4. Rien dans aucun des blocs ne nomme la direction du protocole. Le placement détermine la direction, donc la même bibliothèque de requêtes ou le binaire nginx peut servir les deux côtés.
Choisir la bonne direction de proxy pour votre travail
Utilisez une question avant de choisir un produit, un protocole ou un pool d'IP :
Contrôle-je le client effectuant la demande, ou contrôle-je le service le recevant ?
Si vous contrôlez le client, choisissez un proxy avant lorsque vous devez gouverner les connexions sortantes. Cela couvre un gestionnaire de médias sociaux coordonnant des espaces de travail de compte approuvés, un spécialiste de la vérification des publicités vérifiant la livraison régionale, une équipe de recherche observant les prix localisés, et un ingénieur QA testant un comportement dépendant de la géographie.
Si vous contrôlez le service, choisissez un proxy inverse lorsque vous devez gouverner les connexions entrantes. Cela couvre le routage des visiteurs à travers des serveurs d'application, la centralisation du traitement TLS, la mise en cache des réponses répétables, l'application de l'authentification avant l'application, et le maintien de l'infrastructure d'origine derrière une passerelle publique.
Adapter le réseau au flux de travail
Pour le travail sortant, le type de réseau affecte ce que les destinations peuvent inférer :
- Mobile 4G/5G convient aux tests et à la recherche où le contexte du réseau de l'opérateur est important.
- Résidentiel convient aux flux de travail qui nécessitent une classification de réseau domestique et une large couverture régionale.
- Datacenter convient aux environnements contrôlés où la vitesse et une infrastructure prévisible comptent plus que des signaux de réseau semblables à ceux des abonnés.
Ensuite, décidez si la tâche nécessite une rotation ou une continuité. Utilisez rotation pour des observations séparées à travers des contextes de réseau. Utilisez sessions collantes lorsqu'un navigateur, une connexion, un panier ou un flux QA multi-étapes doit conserver un chemin cohérent. Vérifiez l'emplacement apparent et l'ASN au lieu de faire confiance uniquement à une étiquette de pays.
Un proxy inverse ne masquera pas un visiteur du site web auquel il accède. Il représente le site web aux visiteurs et cache l'infrastructure d'origine du site, pas l'identité du visiteur de ce site. De même, un proxy avant mobile ne remplace pas l'autorisation, les contrôles de taux, la sécurité des points de terminaison ou les garanties d'utilisation légale.
Pour la gestion des médias sociaux, la recherche de marché, la vérification des publicités et le QA sensible à la géographie, un proxy avant mobile 4G est la direction pertinente lorsque le client a besoin d'un chemin sortant associé à l'opérateur. Gardez le flux de travail conforme, documentez pourquoi chaque contexte de réseau est nécessaire, et mesurez l'achèvement réussi des tâches plutôt que de poursuivre une étiquette d'anonymat abstraite.
Evoproxy fournit une connectivité mobile 4G avec des ports personnels et partagés, une rotation configurable, et un accès à des adresses IP mobiles pour des flux de travail sortants. Si votre équipe a besoin de tester un chemin de réseau d'opérateur pour des travaux sociaux, de recherche, de publicité ou de QA, visitez Evoproxy et choisissez une configuration qui correspond aux exigences de session et de conformité de votre cas d'utilisation.


