Une campagne est sur le point de se lancer, un flux de paiement est en cours de réécriture, ou une équipe d'application mobile doit valider le comportement de l'API à travers les régions. Le modèle de trafic est suffisamment clair. La décision concernant les outils ne l'est généralement pas. Vous pouvez choisir un cadre orienté code, un enregistreur guidé par une interface graphique, un cheval de bataille open-source, ou une plateforme gérée qui cache la plupart de l'infrastructure. Chaque choix modifie la rapidité avec laquelle vous pouvez construire des tests, la facilité avec laquelle vous pouvez les maintenir, et la charge opérationnelle que vous héritez plus tard.
Les tests de charge sont une demande simulée utilisée pour évaluer les temps de réponse, le débit, le comportement d'erreur, et la stabilité globale du système sous une utilisation concurrente. En pratique, de bons tests de charge répondent à des questions très pratiques. L'authentification s'effondrera-t-elle sous des connexions maximales ? La limitation de débit se comportera-t-elle correctement ? Un flux de paiement régional ralentira-t-il lorsqu'une campagne envoie des utilisateurs de plusieurs pays à la fois ?
Les bons points de comparaison sont simples. Regardez le modèle de script, le support des protocoles, les options d'exécution distribuée, la qualité des rapports, l'approche tarifaire, la charge de maintenance, et si l'outil peut supporter des tests géographiques responsables lorsque la localisation est importante.
Ce dernier point est souvent mal compris. Les proxies mobiles, résidentiels et de centre de données résolvent différents problèmes d'origine IP et de tests de localisation. Ce ne sont pas des générateurs de charge, et ce ne sont pas des simulateurs de navigateur. Utilisez-les uniquement lorsque le flux d'application dépend de la géographie, de l'ASN ou de l'identité réseau. Si vous validez simplement la capacité de l'API, ils ajoutent souvent du bruit dont vous n'avez pas besoin.
1. Apache JMeter
Apache JMeter reste la réponse par défaut lorsqu'une équipe a besoin d'une large couverture de protocoles sans friction de licence. Apache le décrit comme une application 100 % Java conçue pour tester la charge du comportement fonctionnel et mesurer la performance, ce qui explique pourquoi il convient toujours bien aux backends riches en protocoles et aux travaux CI réutilisables. Il est particulièrement utile lorsqu'une équipe doit tester des API, des bases de données, des files d'attente et des modèles de service plus anciens depuis un seul endroit.
Un schéma courant est une équipe QA validant l'enregistrement de compte, la réinitialisation de mot de passe, et la gestion de session avant un lancement. Un autre est une équipe d'affiliation ou de croissance testant sous pression un chemin d'API de page d'atterrissage avant que le trafic payant n'augmente. JMeter fonctionne bien ici car vous pouvez commencer petit, réutiliser des éléments de test, et ajouter des assertions sans reconstruire tout le cadre de test.
Où JMeter s'intègre le mieux
JMeter est le plus fort lorsque la surface de test est plus large que le simple HTTP.
- Validation multi-protocole : Il convient aux équipes testant des points de terminaison web, des flux soutenus par JDBC, ou des intégrations de services dans un même projet.
- Répétabilité scriptable : L'exécution CLI facilite l'exécution de vérifications programmées dans CI/CD après que le plan de test soit stable.
- Coût d'entrée faible : L'open source est important lorsqu'une équipe a besoin de nombreuses exécutions répétées et ne veut pas impliquer les achats.
Règle pratique : Commencez avec une base et augmentez progressivement. Les pics soudains sont utiles pour les tests de stress, mais ils ne sont pas un bon premier passage pour comprendre le comportement normal.
Il est également utile de séparer la latence cible des problèmes de chemin réseau. Avant de blâmer l'application, vérifiez le chemin, le comportement DNS, et le chemin proxy si vous en utilisez un. Un simple flux de test de vitesse de proxy est souvent suffisant pour attraper le bruit de l'environnement de test avant qu'il ne pollue vos résultats.
Le principal inconvénient de JMeter est la maintenance. La corrélation peut devenir désordonnée lorsque des jetons, des ID dynamiques, et des états chaînés sont partout. C'est toujours l'un des outils de test de charge les plus pratiques, mais il récompense les équipes qui traitent les plans de test comme des actifs, et non comme des scripts jetables.
2. Gatling
Gatling est mieux adapté lorsque les développeurs veulent que les tests de charge se comportent comme du code d'application. Vous définissez des scénarios dans le code, les engagez dans le contrôle de version, examinez les modifications dans les demandes de tirage, et les exécutez dans des pipelines. Ce flux de travail est important lorsque les tests de performance doivent évoluer avec le service au lieu d'être détenus par une île QA séparée.
Pour l'intégration SaaS, les parcours de paiement, ou les API de vérification d'annonces avec une logique conditionnelle, Gatling semble généralement plus propre qu'un outil guidé par une interface graphique. Les flux multi-étapes sont plus faciles à lire lorsque chaque requête, pause, alimentateur, et assertion se trouve dans le code à côté du reste du scénario. Les équipes qui se soucient d'un rythme réaliste bénéficient également de temps de réflexion explicites et de logique de branchement.
Ce que Gatling fait bien
Le plus grand avantage est la maintenabilité sous changement. Si votre flux d'authentification change à chaque sprint, le code vieillit généralement mieux que les scripts enregistrés.
- Lisibilité des scénarios : Les alimentateurs, les requêtes chaînées, et les assertions rendent les chemins critiques pour l'entreprise plus faciles à modéliser.
- Flux de travail des développeurs : Le code de test vit dans Git, donc les vérifications de performance peuvent évoluer avec les branches de version.
- Rapports pour les parties prenantes : Les rapports de Gatling sont généralement plus faciles à partager avec des non-spécialistes que des journaux bruts ou des exports CSV.
Un cas d'utilisation pratique est la validation de la livraison d'annonces régionales. Une équipe de vérification d'annonces peut avoir besoin de simuler le suivi des impressions, les redirections de page d'atterrissage, et la journalisation des rappels tout en préservant la logique de session. Gatling peut bien modéliser cela, mais la couche géographique doit rester séparée du modèle de charge. Ajoutez la rotation de proxy uniquement si le comportement de réponse régional fait partie de l'objectif du test.
Le compromis est évident. Gatling est moins convivial pour les équipes qui souhaitent une rédaction point-and-click, et ce n'est pas le premier choix lorsque la diversité des protocoles est plus importante que l'ergonomie des développeurs. Mais pour les flux API et web orientés code, c'est l'une des options les plus propres.
3. LoadRunner
LoadRunner se situe dans la catégorie des outils que vous choisissez parce que le système à tester est compliqué, et non parce que la configuration est légère. Il est généralement utilisé lorsqu'une entreprise a besoin d'enregistrement, de lecture, d'analytique, et de diagnostics d'entreprise plus approfondis dans une seule plateforme. Cela s'applique souvent aux systèmes financiers, aux flux d'authentification des télécommunications, et aux grandes piles de vente au détail avec de nombreuses pièces mobiles.
L'attrait réside dans l'étendue. Lorsque les scripts nécessitent corrélation, paramétrage, gestion des transactions, et surveillance coordonnée à travers les couches d'application et d'infrastructure, LoadRunner peut soutenir une pratique de performance disciplinée. Les équipes l'utilisent souvent pour des systèmes où un test échoué a un coût commercial direct, comme l'orchestration des paiements ou les fenêtres de connexion à fort volume.
Quand LoadRunner justifie sa complexité
Cet outil a plus de sens lorsque l'environnement lui-même est coûteux et politiquement sensible. Dans ce contexte, plus de contrôle et plus d'analytique peuvent valoir le coût de configuration.
- Flux de travail enregistrés : Utile pour les équipes qui ont besoin de capturer des interactions et de les affiner plutôt que de tout coder à la main.
- Applications lourdes en corrélation : Mieux adaptées aux flux avec des jetons dynamiques, un état de session, et un comportement de lecture fragile.
- Alignement de l'observabilité d'entreprise : Plus fort lorsque les ingénieurs de performance doivent aligner les événements de charge avec la télémétrie côté serveur.
Les meilleurs projets LoadRunner ne cherchent pas d'abord à maximiser les utilisateurs virtuels. Ils verrouillent des transactions réalistes, la gestion des valeurs dynamiques, et la couverture de surveillance avant de se développer.
Pour la validation dépendante de la géographie, le même avertissement s'applique qu'avec toute plateforme d'entreprise. N'utilisez pas de proxies simplement parce que la page produit dit "global". Utilisez-les lorsque la région, le chemin du transporteur, ou l'identité IP modifient le comportement de l'application. Sinon, ils peuvent brouiller la distinction entre le test de l'application et celui du réseau qui l'entoure.
4. Locust
Locust est ce que de nombreuses équipes Python choisissent lorsqu'elles veulent de la vitesse, de la flexibilité, et très peu de cérémonial. Vous écrivez le comportement des utilisateurs en Python, l'exécutez localement ou en mode distribué, et itérez rapidement. Cette simplicité est la raison pour laquelle il fonctionne bien pour les startups, les équipes de plateforme internes, et les services riches en API où les développeurs vivent déjà en Python.
Une plateforme de gestion des médias sociaux est un bon exemple. Si l'équipe doit tester la gestion des connexions concurrentes, le rafraîchissement de session, le polling des tâches, et les rappels webhook, Locust peut exprimer cette logique sans beaucoup de surcharge de cadre. Il en va de même pour les pipelines de recherche de marché ou les services de suivi des clics qui nécessitent des vérifications de régression répétées dans CI.
Pourquoi les équipes Python aiment Locust
Locust a tendance à gagner sur la familiarité, pas sur le surplus de fonctionnalités.
- Code de test Python pur : Pas de DSL séparé à apprendre.
- Itération rapide : Il est facile de remplacer les données de test, la logique d'authentification personnalisée ou les bibliothèques d'aide.
- Exécutions distribuées : L'évolutivité horizontale est simple une fois que les scénarios sont stables.
Un modèle pratique est de modéliser des classes d'utilisateurs au lieu d'un flux générique de requêtes. Un type d'utilisateur peut se connecter et lire des données. Un autre peut créer des enregistrements. Un troisième peut interroger des points de terminaison de statut. Cela vous donne un mélange de trafic plus réaliste que de frapper un point de terminaison parce que c'est facile.
Locust fonctionne également bien avec les tests d'IP d'origine lorsque cela est nécessaire. Si une équipe vérifie la limitation de débit régionale ou les réponses géolockées, des proxies 4G mobiles peuvent être ajoutés au niveau de la requête. Il suffit de garder l'objectif étroit. Locust doit toujours mesurer le comportement de l'application, pas servir de vague « remplacement de navigateur ».
Son point le plus faible est la largeur de protocole prête à l'emploi. Si votre équipe a besoin de nombreux flux de travail non-HTTP sans construire d'adaptateurs, un autre outil vous y amènera généralement plus rapidement.
5. K6
K6 est l'un des outils les plus adaptés pour les équipes axées sur DevOps qui souhaitent que les tests de performance fonctionnent comme n'importe quel autre contrôle automatisé. Les tests sont écrits en JavaScript et exécutés par un moteur basé sur Go, ce qui rend le modèle d'auteur accessible à de nombreux ingénieurs web et de plateforme. Si l'objectif est « exécuter cela à chaque commit, échouer la construction en cas de dépassement de seuil », K6 est généralement en haut de la liste restreinte.
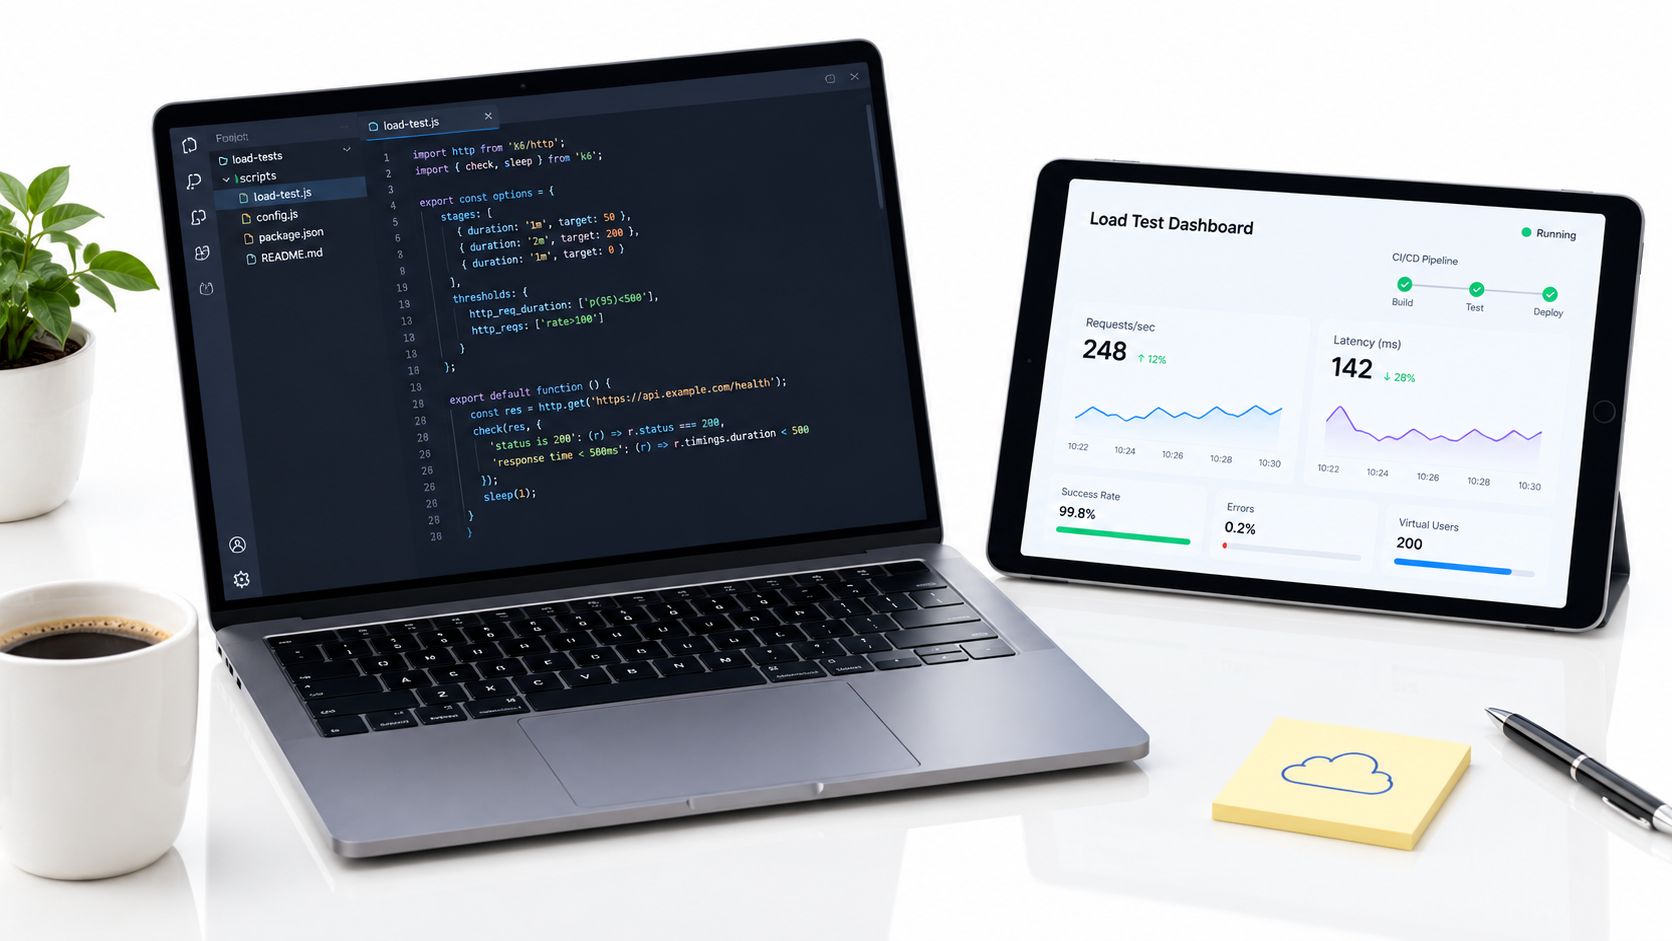
Il fonctionne particulièrement bien pour les contrats API qui nécessitent à la fois des portes de performance et de correction. Une plateforme d'automatisation marketing, par exemple, pourrait valider les appels de pixels de suivi, l'ingestion d'événements et les API de rappel avant chaque déploiement. K6 maintient cela proche des flux de travail d'ingénierie normaux.
Où K6 est le plus fort
K6 brille lorsque le code de test, CI et l'observabilité doivent tous s'aligner.
- Script JavaScript : Familier pour les équipes qui construisent déjà des services frontend ou basés sur Node.
- Automatisation basée sur des seuils : Utile lorsque les décisions de publication dépendent de conditions de réussite ou d'échec claires.
- Options d'exécution cloud et locale : Bon pour les équipes qui commencent petit et s'étendent plus tard.
Une estimation indépendante du marché projette le segment des outils de test de performance à 1,87 milliard USD en 2026 et 3,59 milliards USD d'ici 2031, avec un TCAC de 13,97%. Une autre estimation dans cette même source place le marché plus large à 1,6 milliard USD en 2024 et projette 17,0 milliards USD d'ici 2034, avec les tests de charge représentant 45,2 % du segment des types de tests. En termes pratiques, des outils comme K6 s'inscrivent dans le changement plus large vers la validation continue au sein de DevOps, et non des exercices de référence occasionnels.
K6 est moins attrayant lorsque vous avez besoin d'un large support de protocole hérité. Ce n'est pas non plus là où je commencerais avec une équipe QA non technique qui souhaite une rédaction visuelle. Mais pour les flux de travail API modernes, il est efficace et facile à opérationnaliser.
6. Neoload
Neoload est le type d'outil que les équipes choisissent lorsqu'elles souhaitent des fonctionnalités d'entreprise sans pousser tout le monde vers une rédaction axée sur le code. Il convient souvent mieux aux équipes mixtes où QA, ingénierie de performance et opérations de plateforme ont tous besoin de visibilité sur les mêmes tests. L'enregistrement des flux de travail et l'analyse des régressions peuvent être plus rapides lorsque l'outil fait plus de travail de configuration pour vous.
Cela compte dans des domaines comme l'intégration bancaire numérique, la validation de publication de plateformes de streaming ou les moteurs de réservation de voyages avec de nombreux états et appels tiers. Dans ces environnements, un script de test qui survit au changement est plus précieux qu'un script qui semblait élégant le premier jour.
Meilleure utilisation de Neoload
Neoload a tendance à mieux fonctionner lorsque la profondeur du protocole et le diagnostic comptent plus que la flexibilité open-source.
- Capture de flux de travail : Utile pour des parcours multi-étapes avec des données de session dynamiques.
- Utilisabilité inter-équipes : Plus facile à répartir entre QA et ingénierie que certains outils uniquement codés.
- Analyse de régression : Mieux adapté aux cycles de test répétés qu'aux exécutions de référence ponctuelles.
Beaucoup d'équipes sous-estiment la différence entre le test de stress une fois et l'échelle d'une pratique de performance répétable. C'est là qu'une approche disciplinée des méthodes de test de scalabilité aide. Vous avez besoin d'étapes de charge planifiées, de conditions de réussite claires et d'une observabilité suffisante pour savoir si les échecs proviennent du code, de l'infrastructure ou de la chaîne de dépendance.
Neoload n'est pas l'option la plus légère pour une startup validant une simple API REST. Mais si vous testez des parcours utilisateurs larges, des applications packagées ou des systèmes sensibles à l'infrastructure, cela peut faire gagner du temps qui autrement disparaîtrait dans la réparation de scripts et l'interprétation des résultats.
7. Artillery
Artillery est une option pratique pour les équipes Node.js et les programmes API qui souhaitent quelque chose de plus léger qu'une suite d'entreprise lourde. Les scénarios YAML rendent les tests simples rapides à écrire, et les hooks JavaScript ajoutent de la flexibilité lorsqu'un flux a besoin de valeurs dynamiques, de configurations personnalisées ou de validations de réponse. Cette combinaison est utile pour les branches de fonctionnalités, les vérifications de niveau de service et les portes de performance répétées dans CI.
Une plateforme martech est un bon choix. Une équipe pourrait valider la journalisation des impressions et l'ingestion d'événements sur chaque branche. Une autre pourrait exercer une API d'inscription régionale avant le lancement d'une campagne. Artillery garde ce travail proche de la pile JavaScript existante.
Pourquoi les équipes choisissent Artillery
Artillery concerne moins l'ambition de protocole large et plus la vitesse des flux de travail.
- YAML pour des scénarios communs : Bon pour faire fonctionner rapidement des tests utiles.
- Extensibilité JavaScript : Utile lorsque des chaînes de requêtes simples deviennent des flux d'état.
- Orientation microservices : Fonctionne bien pour les systèmes centrés sur HTTP qui changent souvent.
"Gardez le script de test plus simple que le service que vous testez." Si votre scénario Artillery commence à recréer l'ensemble de votre machine d'état d'application, le test deviendra un problème de maintenance.
Lorsque l'emplacement compte, les décisions de routage doivent rester explicites. Si vous vérifiez comment une campagne se déroule depuis différentes régions, ou si une règle de bord se comporte différemment selon l'origine, une configuration de proxy de répartition de charge peut aider à structurer les chemins de trafic. Mais cela ne remplace toujours pas la véritable génération de charge distribuée. Cela ne change que d'où semblent provenir les requêtes.
Artillery n'est pas la meilleure réponse pour des besoins de protocole d'entreprise profonds. Pour des services HTTP en rapide évolution, cependant, il est facile de justifier.
8. BlazeMeter
BlazeMeter attire les équipes qui souhaitent une exécution distribuée sans gérer et maintenir toute l'infrastructure elles-mêmes. Il est particulièrement attrayant lorsqu'une entreprise possède déjà des actifs de script et a besoin d'un moyen géré pour les exécuter depuis plusieurs régions, collecter des résultats et les partager entre les équipes.
Ce modèle convient aux lancements de commerce électronique, à la validation de publication fintech et aux vérifications de capacité de réseau publicitaire où l'équipe souhaite de l'échelle mais ne veut pas passer son temps à faire fonctionner des générateurs de charge. L'exécution gérée peut également réduire les frictions internes car l'environnement de test devient plus facile à standardiser.
Exécution gérée sans construire la grille
BlazeMeter est utile lorsque la gestion de l'infrastructure est la partie que votre équipe souhaite éviter.
- Échelle basée sur le cloud : Mieux pour les organisations qui ne souhaitent pas maintenir des générateurs distribués.
- Rapports partagés : Plus facile de socialiser les résultats entre l'ingénierie, QA et les opérations.
- Portabilité des scripts : Utile pour les équipes étendant des pratiques de performance existantes au lieu de repartir de zéro.
Un deuxième problème pratique est la forme des coûts. Une couverture indépendante de 2026 note que Grafana Cloud offre une allocation gratuite de 500 VUh, tandis que Locust et JMeter restent gratuits à n'importe quelle échelle. Cette même source indique que le marché devrait passer de 2,8 milliards USD en 2025 à 7,1 milliards USD d'ici 2034 avec un TCAC de 10,9 %, et décrit la demande des PME comme le segment à la croissance la plus rapide. La leçon n'est pas gratuite contre payante. C'est que l'exécution répétée, l'infrastructure des générateurs, le temps de script et les frais d'intégration devraient tous être tarifés comme un seul système.
BlazeMeter a du sens lorsque la distribution gérée est le goulet d'étranglement. Si votre véritable problème est un design de test faible ou une observabilité médiocre, un plan de contrôle cloud ne résoudra pas cela.
9. WebLOAD
WebLOAD a l'une des lignes historiques les plus claires dans cette catégorie. Il a été lancé pour la première fois en août 1997, et son historique de versions documenté comprend plus de 20 versions, avec des jalons tels que les tests de charge cloud en 2012, le support mobile et IPv6 en 2013, l'intégration Jenkins en 2013, et les tests WebSockets en 2014, comme résumé dans l'historique documenté de WebLOAD. Cette chronologie est importante car elle montre comment les outils de test de charge ont évolué d'une simple vérification de stress HTTP à des plateformes plus larges liées au cloud, CI/CD, mobile et protocoles modernes.
Pour les praticiens, WebLOAD est intéressant lorsque l'environnement mélange des flux de travail semblables à ceux des navigateurs, des API et des besoins de livraison d'entreprise larges. Les caisses de détail, les portails patients et les flux bancaires en ligne tombent souvent dans cette catégorie car les tests nécessitent à la fois flexibilité de script et beaucoup de contexte diagnostique.
Pourquoi WebLOAD est toujours pertinent
Les outils de longue durée survivent parce qu'ils résolvent des problèmes de maintenance de script et de flux de travail d'équipe, et non parce qu'ils ont l'interface utilisateur la plus flashy.
- Modèle opérationnel hybride : Utile pour les équipes qui ont besoin d'un IDE et d'options d'exécution cloud.
- Support de parcours complexe : Mieux adapté aux chemins d'application lourds en AJAX ou à état.
- Maturité opérationnelle : Les intégrations comme le support CI comptent plus que le marketing une fois que les tests deviennent routiniers.
Une note pratique. WebLOAD est souvent meilleur lorsqu'une équipe de performance souhaite plus de structure que ce que les frameworks open-source fournissent généralement, mais ne veut pas construire chaque partie de l'environnement de test. Il est moins convaincant pour une petite équipe avec une API et une forte culture de code d'abord.
10. Taurus
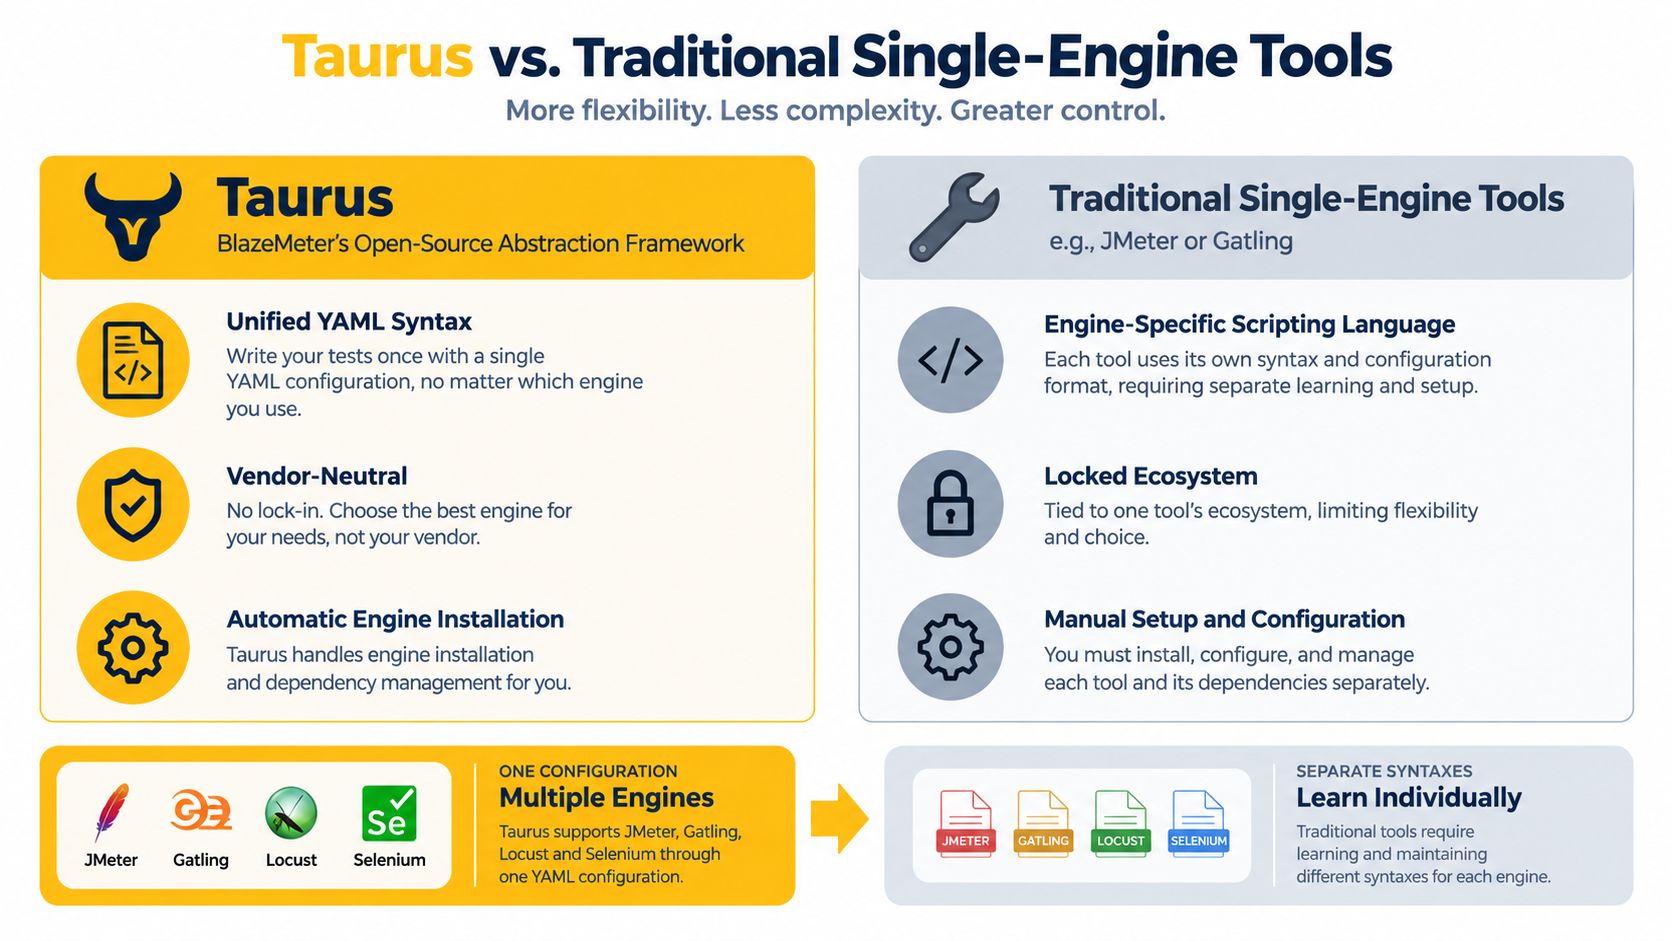
Taurus est moins un moteur de charge qu'une couche unificatrice. C'est ce qui le rend précieux. Si une équipe utilise JMeter, une autre utilise Locust, et une troisième souhaite standardiser l'exécution CI sans forcer une réécriture, Taurus peut lisser cela grâce à une configuration et un traitement des résultats pilotés par YAML.
C'est utile dans les entreprises, mais aussi dans les plus petites organisations où l'éparpillement des outils s'est produit naturellement. Une équipe de croissance peut avoir une suite JMeter héritée pour les points de terminaison de campagne, tandis qu'une équipe backend exécute des vérifications basées sur Python ailleurs. Taurus donne aux deux groupes un moyen de converger opérationnellement avant de converger techniquement.
Où Taurus a du sens
Taurus est un choix pratique lorsque la standardisation est plus urgente que le remplacement.
- Couche d'exécution unifiée : Utile pour les organisations avec plusieurs moteurs en utilisation active.
- Onboarding simplifié : Les nouveaux contributeurs peuvent commencer avec YAML au lieu d'apprendre chaque syntaxe native à la fois.
- Support de migration : Utile lorsque les équipes comparent des moteurs ou changent progressivement de propriété.
Un signal de marché soutient pourquoi les couches d'abstraction sont importantes. Les données d'adoption indépendantes indiquent que plus de 9 200 entreprises utilisent des outils de performance et de test de charge, et JMeter à lui seul représente environ 56,30 % de ce marché suivi, avec 5 180 clients, selon le résumé d'adoption cité dans cette revue de marché. En termes simples, de nombreuses équipes ont déjà JMeter quelque part. Taurus aide lorsque l'objectif est d'organiser cette réalité au lieu de prétendre que tout le monde va changer en même temps.
Ce n'est pas une panacée. Si les scripts sous-jacents sont faibles, Taurus ne les rendra pas forts. Mais il peut rendre les environnements à outils mixtes beaucoup plus faciles à gérer.
Comparaison des 10 meilleurs outils de test de charge
| Outil | Fonctionnalités principales | UX / Qualité (★) | Prix (💰) | Cible (👥) | Points de vente uniques (✨ / 🏆) |
|---|---|---|---|---|---|
| Apache JMeter | Échantillonneurs multi-protocoles (HTTP, FTP, JDBC, SOAP) ; tests distribués ; plugins | ★★★★, reporting mature ; courbe d'apprentissage plus raide | 💰 Gratuit, open-source | 👥 Équipes QA, entreprises, testeurs ayant besoin d'une large couverture de protocoles | ✨ Large support de protocoles & écosystème de plugins ; 🏆 grande communauté |
| Gatling | DSL Scala, rythme utilisateur réaliste, charge efficace sur une seule machine | ★★★★, code d'abord, excellent pour les développeurs ; plus difficile pour les non-programmeurs | 💰 OSS gratuit ; entreprise payante | 👥 Équipes de développement, CI/CD, ingénieurs de performance | ✨ Code-en-tests pour des scénarios reproductibles ; haute efficacité |
| LoadRunner | Enregistrement VuGen, 50+ protocoles, surveillance et traçage côté serveur | ★★★★★, diagnostics d'entreprise ; interface complexe | 💰 Licence d'entreprise premium | 👥 Grandes entreprises (finance, télécom) | ✨ Analyse approfondie des causes racines & couverture des protocoles ; 🏆 de niveau entreprise |
| Locust | Scénarios basés sur Python, interface web, travailleurs distribués | ★★★★, très facile pour les utilisateurs de Python ; itération rapide | 💰 Gratuit, open-source | 👥 Startups, équipes Python, testeurs agiles | ✨ Script Python simple + contrôle web en temps réel |
| K6 | Tests JavaScript, moteur Go, mise à l'échelle locale/cloud, seuils | ★★★★, convivial pour DevOps, intégration CI fluide | 💰 OSS gratuit + niveaux cloud payants | 👥 DevOps, développeurs JS, pipelines CI | ✨ Tests natifs JS avec mise à l'échelle cloud & métriques en streaming |
| Neoload | Conception de test assistée par IA, détection d'anomalies ML, intégrations riches | ★★★★★, insights IA ; puissant mais complexe | 💰 Premium / entreprise | 👥 Grandes entreprises, systèmes mobiles & complexes | ✨ Corrélation & optimisation pilotées par IA ; 🏆 analyse avancée |
| Artillery | Définitions de test YAML/JS, support WebSocket/SSE, faible surcharge | ★★★, rapide à démarrer ; moins riche en fonctionnalités pour les entreprises | 💰 OSS gratuit ; options payantes | 👥 Startups, équipes Node.js, testeurs axés sur les API | ✨ Simplicité axée sur YAML ; utilisation facile CI/CD |
| BlazeMeter | Mise à l'échelle automatique cloud, compatibilité JMeter, scripting visuel | ★★★★, zéro infra ; génération de charge mondiale | 💰 Payant (basé sur l'utilisation cloud) | 👥 Équipes ayant besoin de tests gérés à grande échelle | ✨ Mise à l'échelle gérée + réutilisation de JMeter ; 🏆 onboarding facile pour les équipes non infra |
| WebLOAD | Modes IDE + cloud, enregistrement de navigateur, scripting semblable à JS | ★★★★, enregistreur puissant ; flux de travail centré sur l'IDE | 💰 Tarification d'entreprise premium | 👥 Entreprises avec des applications web complexes | ✨ Enregistrement de navigateur précis & analyse des transactions |
| Taurus | Abstraction YAML unifiée pour JMeter/Gatling/Locust/Selenium | ★★★, simplifie l'orchestration ; ajoute une couche d'abstraction | 💰 Gratuit, open-source | 👥 Organisations standardisant à travers les outils | ✨ YAML agnostique au moteur ; exécute plusieurs moteurs à partir d'une seule configuration |
Transformez la liste restreinte en un plan de test responsable
Le choix de l'outil devient plus facile lorsque vous partez du flux de travail, et non de la marque. Choisissez Apache JMeter lorsque vous avez besoin d'une large couverture de protocoles et qu'il n'y a pas de coût de licence. Optez pour Gatling ou K6 lorsque l'équipe souhaite des tests axés sur le code qui s'intègrent naturellement dans CI/CD. Utilisez Locust ou Artillery lorsque la culture d'ingénierie est fortement Python ou Node.js et que la cible est principalement du trafic HTTP ou API. Optez pour LoadRunner, Neoload ou WebLOAD lorsque les diagnostics d'entreprise, l'enregistrement ou les réalités de protocoles plus larges comptent plus que des outils minimalistes. BlazeMeter convient à l'exécution distribuée gérée. Taurus est pertinent lorsque plusieurs moteurs existent déjà et que vous avez besoin d'une couche opérationnelle unique entre eux.
La décision la plus importante est de savoir comment vous exécutez le test. Commencez par définir l'objectif légitime. Validez la stabilité de la caisse, la livraison d'annonces régionales, la résilience de l'inscription au compte, la gestion des pics d'API, ou un autre chemin commercial concret. Ne commencez pas par « voir combien de trafic il peut supporter ». Cela crée généralement des données bruyantes et aucune décision utile.
Utilisez la mise en scène chaque fois que possible, ou utilisez des fenêtres de production approuvées avec une propriété claire et des plans de retour en arrière. Établissez d'abord une ligne de base, puis définissez des seuils de réussite et d'échec pour la latence, les erreurs et le débit. Décidez quelles régions sont importantes. Une campagne sensible à la géographie, un flux de tarification localisé ou un parcours de conformité spécifique à un pays peuvent justifier des tests basés sur la région. Une API interne générique ne le fera généralement pas.
Les proxies n'appartiennent qu'aux parties du plan où l'identité d'origine change le comportement du système. Les IP de datacenter conviennent pour de nombreux chargements en arrière-plan et sont généralement l'option la plus simple. Les IP résidentielles sont utiles lorsque vous avez besoin d'origines ressemblant à des consommateurs. Les proxies mobiles résolvent un problème plus étroit. Ils sont pertinents lorsque vous devez valider des expériences dépendantes du réseau mobile, un comportement sensible aux opérateurs ou des modèles d'identité régionale qui diffèrent de la large bande fixe.
Cette distinction est importante car les IP mobiles 4G et 5G sont plus difficiles à bloquer avec des règles IP simples. Les opérateurs placent de nombreux abonnés derrière un NAT de qualité opérateur, donc une IP mobile peut représenter un grand nombre d'utilisateurs réels, ce qui rend le blocage basé sur l'IP risqué et pousse les systèmes vers la détection comportementale à la place, comme expliqué dans cet aperçu du NAT de qualité opérateur et des plages de proxies mobiles. Si votre application se comporte différemment pour le trafic d'origine mobile, c'est une variable QA valide. Si ce n'est pas le cas, ajouter des IP mobiles peut simplement compliquer l'analyse.
Il en va de même pour les choix de protocole et de session. Les proxies HTTP(S) sont généralement suffisants pour le trafic web standard. SOCKS5 est plus flexible lorsque vous avez besoin d'un modèle de proxy de transport plus large, et les services offrent souvent les deux ensemble, comme décrit dans cet aperçu des protocoles de proxy. Ensuite, décidez si vous avez besoin de rotation ou de continuité. Les sessions tournantes changent fréquemment d'IP et conviennent à la collecte à fort volume ou à un échantillonnage large. Les sessions collantes conservent la même IP de sortie pendant une période définie, ce qui est mieux pour les flux basés sur la connexion, l'état du compte et tout parcours qui dépend de la continuité de la session, comme décrit dans ce guide sur les sessions tournantes et collantes.
Surveillez le comportement de l'application et les effets du proxy séparément. Cela signifie suivre les temps de réponse, le débit et les erreurs de l'outil de charge tout en observant si le chemin du proxy ajoute de la latence, modifie les en-têtes ou altère la résolution géographique. Documentez le consentement, les fenêtres d'utilisation approuvées et les contraintes des conditions de service avant tout test qui touche des plateformes tierces ou des propriétés publiques. L'automatisation responsable a toujours un but commercial et des garde-fous explicites.
Si votre équipe a besoin de QA dépendante de la géographie, de validation de campagne régionale, de recherche de marché ou d'autres flux de travail sensibles à l'origine conformes, Evoproxy est une option à évaluer aux côtés des outils de test de charge eux-mêmes. La bonne pile est généralement une combinaison : un outil pour générer la charge, une couche de surveillance pour le diagnostic, et une approche de proxy uniquement là où la géographie ou l'identité du réseau appartient au test.
Si vous avez besoin d'IP mobiles françaises pour la QA dépendante de la géographie, la validation de campagne, la recherche de marché ou les tests de flux de travail multi-comptes, Evoproxy propose une connectivité mobile 4G conçue pour ces scénarios sensibles à l'origine. Cela vaut la peine d'évaluer lorsque votre plan de test dépend de l'identité réelle du réseau mobile plutôt que du trafic générique de datacenter. Visitez Evoproxy pour voir si ses proxies mobiles 4G correspondent à votre flux de travail spécifique.


