Una campaña está a punto de lanzarse, un flujo de pago se está reescribiendo, o un equipo de aplicaciones móviles necesita validar el comportamiento de la API en diferentes regiones. El modelo de tráfico es lo suficientemente claro. La decisión sobre las herramientas generalmente no lo es. Puedes elegir un marco de trabajo basado en código, un grabador guiado por GUI, un caballo de batalla de código abierto, o una plataforma gestionada que oculta la mayor parte de la infraestructura. Cada elección cambia la rapidez con la que puedes construir pruebas, la facilidad con la que puedes mantenerlas, y la carga operativa que heredas más tarde.
Las pruebas de carga son una demanda simulada utilizada para evaluar los tiempos de respuesta, el rendimiento, el comportamiento de errores y la estabilidad general del sistema bajo uso concurrente. En la práctica, las buenas pruebas de carga responden preguntas muy prácticas. ¿Colapsará la autenticación bajo picos de inicio de sesión? ¿Se comportará correctamente la limitación de tasa? ¿Se ralentizará un flujo de pago regional cuando una campaña envíe usuarios de múltiples países a la vez?
Los puntos de comparación correctos son sencillos. Observa el modelo de scripting, el soporte de protocolos, las opciones de ejecución distribuida, la calidad de los informes, el enfoque de precios, la carga de mantenimiento, y si la herramienta puede soportar pruebas geográficas responsables cuando la ubicación importa.
Ese último punto se confunde a menudo. Los proxies móviles, residenciales y de centro de datos resuelven diferentes problemas de prueba de IP de origen y ubicación. No son generadores de carga, y no son simuladores de navegador. Úsalos solo cuando el flujo de la aplicación dependa de la geografía, ASN, o identidad de red. Si solo estás validando la capacidad de la API, a menudo añaden ruido que no necesitas.
1. Apache JMeter
Apache JMeter sigue siendo la respuesta predeterminada cuando un equipo necesita una amplia cobertura de protocolos sin fricción de licencia. Apache lo describe como una aplicación 100% pura de Java diseñada para probar el comportamiento funcional y medir el rendimiento, lo que explica por qué todavía se adapta bien a backends pesados en protocolos y trabajos de CI reutilizables. Es especialmente útil cuando un equipo tiene que probar APIs, bases de datos, colas y patrones de servicio más antiguos desde un solo lugar.
Un patrón común es un equipo de QA validando el registro de cuentas, el restablecimiento de contraseñas y el manejo de sesiones antes de un lanzamiento. Otro es un equipo de afiliados o de crecimiento sometiendo a prueba una API de página de destino antes de que los picos de tráfico pagado ocurran. JMeter funciona bien aquí porque puedes comenzar pequeño, reutilizar elementos de prueba y agregar afirmaciones sin reconstruir todo el arnés de prueba.
Dónde encaja mejor JMeter
JMeter es más fuerte cuando la superficie de prueba es más amplia que un simple HTTP.
- Validación multi-protocolo: Se adapta a equipos que prueban puntos finales web, flujos respaldados por JDBC, o integraciones de servicio en un solo proyecto.
- Repetibilidad scriptable: La ejecución por CLI facilita la realización de verificaciones programadas en CI/CD después de que el plan de prueba esté estable.
- Bajo costo de entrada: El código abierto importa cuando un equipo necesita muchas ejecuciones repetidas y no quiere involucrar a adquisiciones.
Regla práctica: Comienza con una línea base y aumenta gradualmente. Los picos repentinos son útiles para pruebas de estrés, pero son una mala primera pasada para entender el comportamiento normal.
También ayuda separar la latencia objetivo de los problemas de ruta de red. Antes de culpar a la aplicación, verifica la ruta, el comportamiento de DNS y la ruta del proxy si estás usando uno. Un simple flujo de trabajo de prueba de velocidad de proxy es a menudo suficiente para atrapar el ruido del entorno de prueba antes de que contamine tus resultados.
La desventaja de JMeter es el mantenimiento. La correlación puede volverse desordenada cuando los tokens, IDs dinámicos y estados encadenados están por todas partes. Sigue siendo una de las herramientas de prueba de carga más prácticas, pero recompensa a los equipos que tratan los planes de prueba como activos, no como scripts desechables.
2. Gatling
Gatling es una mejor opción cuando los desarrolladores quieren que las pruebas de carga se comporten como código de aplicación. Defines escenarios en código, los comprometes al control de versiones, revisas cambios en solicitudes de extracción, y los ejecutas en pipelines. Ese flujo de trabajo importa cuando las pruebas de rendimiento necesitan evolucionar con el servicio en lugar de ser propiedad de una isla de QA separada.
Para la incorporación de SaaS, viajes de pago, o APIs de verificación de anuncios con lógica condicional, Gatling generalmente se siente más limpio que una herramienta guiada por GUI. Los flujos de múltiples pasos son más fáciles de leer cuando cada solicitud, pausa, alimentador y afirmación está en código junto al resto del escenario. Los equipos que se preocupan por un ritmo realista también se benefician de tiempos de pensamiento explícitos y lógica de ramificación.
Lo que Gatling hace bien
La mayor ventaja es la mantenibilidad bajo cambio. Si tu flujo de autenticación cambia cada sprint, el código generalmente envejece mejor que los scripts grabados.
- Legibilidad de escenarios: Los alimentadores, solicitudes encadenadas y afirmaciones hacen que los caminos críticos para el negocio sean más fáciles de modelar.
- Flujo de trabajo del desarrollador: El código de prueba vive en Git, por lo que las verificaciones de rendimiento pueden moverse con las ramas de lanzamiento.
- Informes para interesados: Los informes de Gatling suelen ser más fáciles de compartir con no especialistas que los registros en bruto o exportaciones CSV.
Un caso de uso práctico es la validación de entrega de anuncios regionales. Un equipo de verificación de anuncios puede necesitar simular el seguimiento de impresiones, redirecciones de destino y registro de callbacks mientras preserva la lógica de sesión. Gatling puede modelar eso bien, pero la capa geográfica debe permanecer separada del modelo de carga. Agrega rotación de proxy solo si el comportamiento de respuesta regional es parte del objetivo de la prueba.
El compromiso es obvio. Gatling es menos amigable para equipos que quieren autoría de apuntar y hacer clic, y no es la primera opción cuando la diversidad de protocolos importa más que la ergonomía del desarrollador. Pero para flujos de trabajo de API y web basados en código, es una de las opciones más limpias.
3. LoadRunner
LoadRunner se encuentra en la categoría de herramientas que eliges porque el sistema bajo prueba es complicado, no porque la configuración sea ligera. Generalmente se utiliza cuando una empresa necesita grabación, reproducción, análisis y diagnósticos empresariales más profundos en una sola plataforma. Eso a menudo se aplica a sistemas financieros, flujos de autenticación de telecomunicaciones y grandes pilas de retail con muchas partes móviles.
El atractivo es la amplitud. Cuando los scripts necesitan correlación, parametrización, manejo de transacciones y monitoreo coordinado a través de capas de aplicación e infraestructura, LoadRunner puede soportar una práctica de rendimiento disciplinada. Los equipos a menudo lo utilizan para sistemas donde una prueba fallida tiene un costo empresarial directo, como la orquestación de pagos o ventanas de inicio de sesión de alto volumen.
Cuando LoadRunner justifica su complejidad
Esta herramienta tiene más sentido cuando el entorno en sí es costoso y políticamente sensible. En ese contexto, más control y más análisis pueden valer la pena el costo de configuración.
- Flujos de trabajo grabados: Útil para equipos que necesitan capturar interacciones y refinarlas en lugar de codificar todo a mano.
- Aplicaciones con mucha correlación: Mejor adaptadas a flujos con tokens dinámicos, estado de sesión y comportamiento de reproducción frágil.
- Alineación de observabilidad empresarial: Más fuerte cuando los ingenieros de rendimiento necesitan alinear eventos de carga con telemetría del lado del servidor.
Los mejores proyectos de LoadRunner no persiguen primero el máximo de usuarios virtuales. Aseguran transacciones realistas, manejo de valores dinámicos y cobertura de monitoreo antes de escalar.
Para la validación dependiente de la geografía, la misma advertencia se aplica como con cualquier plataforma empresarial. No uses proxies solo porque la página del producto dice "global". Úsalos cuando la región, la ruta del operador o la identidad IP cambien el comportamiento de la aplicación. De lo contrario, pueden difuminar si estás probando la aplicación o la red que la rodea.
4. Locust
Locust es lo que muchos equipos de Python eligen cuando quieren velocidad, flexibilidad y muy poca ceremonia. Escribes el comportamiento del usuario en Python, lo ejecutas localmente o en modo distribuido, y iteras rápido. Esa simplicidad es la razón por la que funciona bien para startups, equipos de plataformas internas y servicios pesados en API donde los desarrolladores ya trabajan en Python.
Una plataforma de gestión de redes sociales es un buen ejemplo. Si el equipo necesita probar el manejo de inicio de sesión concurrente, la actualización de sesiones, la consulta de tareas y los callbacks de webhook, Locust puede expresar esa lógica sin mucho overhead de marco. Lo mismo ocurre con las tuberías de investigación de mercado o los servicios de seguimiento de clics que necesitan verificaciones de regresión repetidas en CI.
Por qué a los equipos de Python les gusta Locust
Locust tiende a ganar en familiaridad, no en sobrecarga de características.
- Código de prueba en Python puro: No hay un DSL separado que aprender.
- Iteración rápida: Es fácil intercambiar datos de prueba, lógica de autenticación personalizada o bibliotecas auxiliares.
- Ejecutar distribuidos: La escalabilidad horizontal es sencilla una vez que los escenarios son estables.
Un patrón práctico es modelar clases de usuarios en lugar de un flujo genérico de solicitudes. Un tipo de usuario puede iniciar sesión y leer datos. Otro puede crear registros. Un tercero puede consultar puntos finales de estado. Eso te da una mezcla de tráfico más realista que golpear un solo punto final porque es fácil.
Locust también funciona bien con pruebas de IP de origen cuando es necesario. Si un equipo está verificando limitaciones de tasa regionales o respuestas bloqueadas geográficamente, se pueden agregar proxies móviles 4G en la capa de solicitud. Solo mantén el propósito estrecho. Locust aún debería medir el comportamiento de la aplicación, no servir como un vago “reemplazo del navegador.”
Su punto más débil es la amplitud de protocolos fuera de la caja. Si tu equipo necesita muchos flujos de trabajo no HTTP sin construir adaptadores, otra herramienta generalmente te llevará allí más rápido.
5. K6
K6 es uno de los ajustes más limpios para equipos con enfoque en DevOps que quieren que las pruebas de rendimiento se ejecuten como cualquier otra verificación automatizada. Las pruebas se escriben en JavaScript y se ejecutan mediante un motor basado en Go, lo que hace que el modelo de autoría sea accesible para muchos ingenieros web y de plataformas. Si el objetivo es “ejecutar esto en cada confirmación, fallar la construcción en violaciones de umbral,” K6 suele estar cerca de la parte superior de la lista corta.
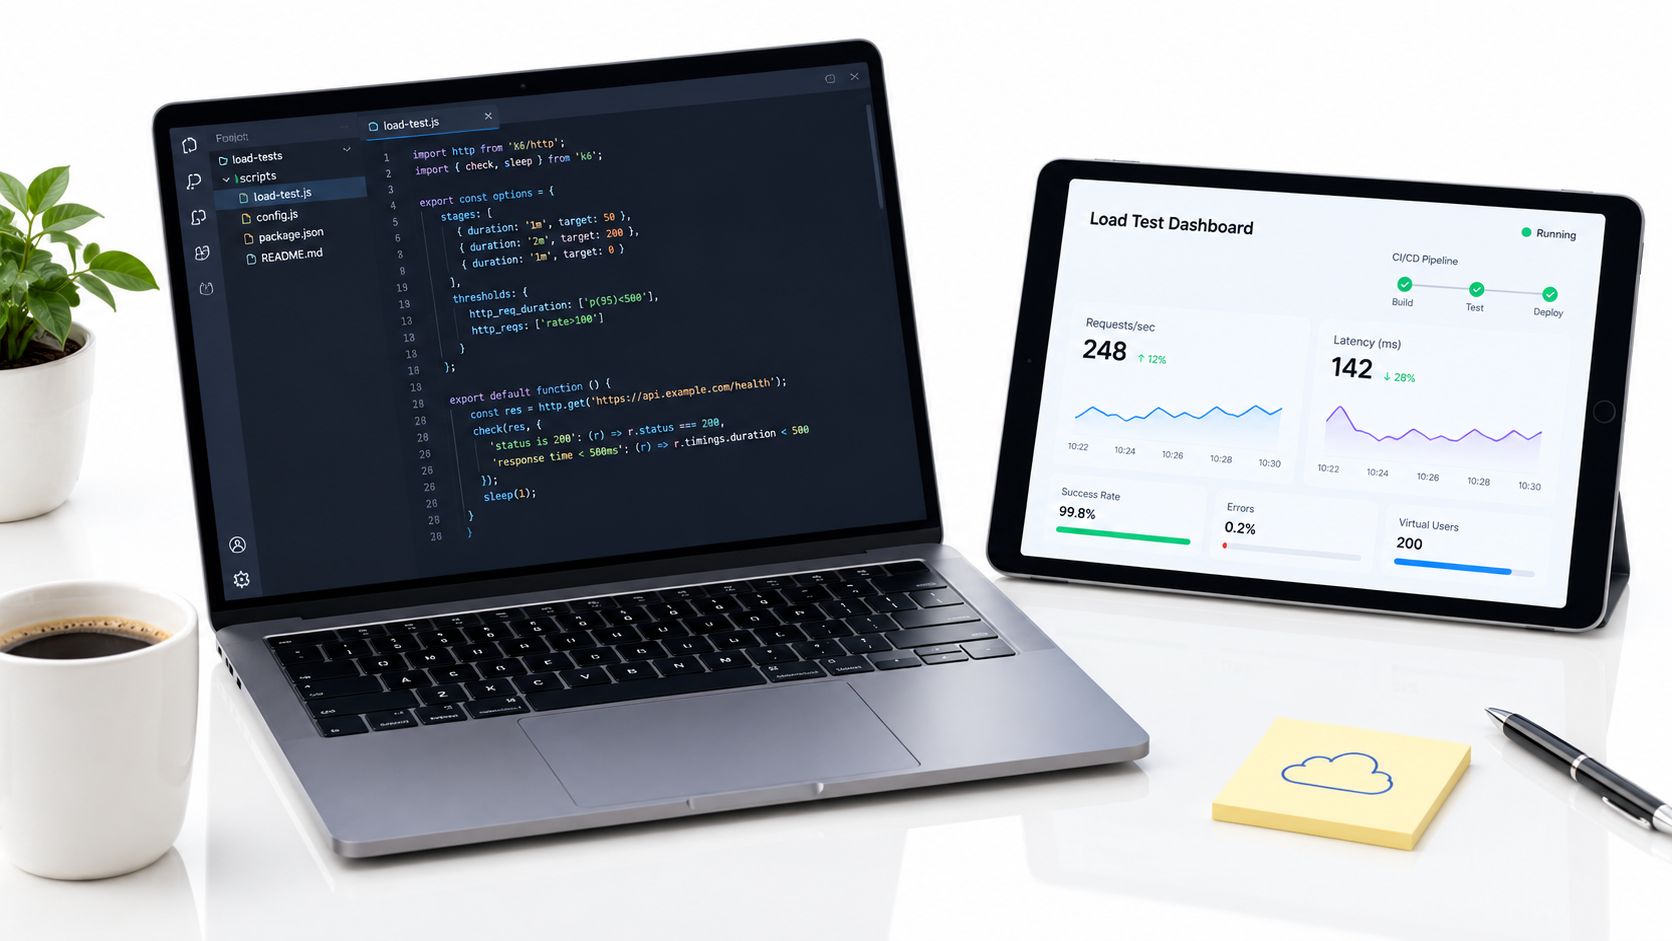
Funciona especialmente bien para contratos de API que necesitan tanto corrección como puertas de rendimiento. Una plataforma de automatización de marketing, por ejemplo, podría validar llamadas de píxeles de seguimiento, ingestión de eventos y APIs de devolución de llamada antes de cada implementación. K6 mantiene eso cerca de los flujos de trabajo de ingeniería normales.
Donde K6 es más fuerte
K6 brilla cuando el código de prueba, CI y la observabilidad necesitan alinearse.
- Script en JavaScript: Familiar para equipos que ya están construyendo servicios frontend o basados en Node.
- Automatización impulsada por umbrales: Útil cuando las decisiones de lanzamiento dependen de condiciones claras de aprobación o rechazo.
- Opciones de ejecución en la nube y local: Bueno para equipos que comienzan pequeños y se expanden más tarde.
Una estimación de mercado independiente proyecta el segmento de herramientas de pruebas de rendimiento en USD 1.87 mil millones en 2026 y USD 3.59 mil millones para 2031, con un CAGR del 13.97%. Otra estimación en esa misma fuente coloca el mercado más amplio en USD 1.6 mil millones en 2024 y proyecta USD 17.0 mil millones para 2034, con las pruebas de carga representando el 45.2% del segmento de tipo de prueba. En términos prácticos, herramientas como K6 se ajustan al cambio más amplio hacia la validación continua dentro de DevOps, no a ejercicios de referencia ocasionales.
K6 es menos atractivo cuando necesitas un amplio soporte de protocolos heredados. También no es donde comenzaría con un equipo de QA no técnico que quiere autoría visual. Pero para flujos de trabajo modernos de API, es eficiente y fácil de operacionalizar.
6. Neoload
Neoload es el tipo de herramienta que los equipos eligen cuando quieren características empresariales sin empujar a todos hacia una autoría basada en código. A menudo es una mejor opción para equipos mixtos donde QA, ingeniería de rendimiento y operaciones de plataforma necesitan visibilidad en las mismas pruebas. Grabar flujos de trabajo y analizar regresiones puede ser más rápido cuando las herramientas hacen más del trabajo de configuración por ti.
Eso importa en lugares como la incorporación de banca digital, validación de lanzamientos de plataformas de streaming o motores de reservas de viajes con muchos estados y llamadas de terceros. En esos entornos, un script de prueba que sobrevive al cambio es más valioso que un script que se veía elegante en el primer día.
Mejor uso para Neoload
Neoload tiende a funcionar mejor cuando la profundidad de protocolo y el diagnóstico importan más que la flexibilidad de código abierto.
- Captura de flujo de trabajo: Útil para viajes de múltiples pasos con datos de sesión dinámicos.
- Usabilidad entre equipos: Más fácil de difundir entre QA e ingeniería que algunas herramientas solo de código.
- Análisis de regresión: Mejor adaptado a ciclos de prueba repetidos que a ejecuciones de referencia únicas.
Muchos equipos subestiman la diferencia entre probar estrés una vez y escalar una práctica de rendimiento repetible. Ahí es donde un enfoque disciplinado hacia métodos de pruebas de escalabilidad ayuda. Necesitas pasos de carga planificados, condiciones de aprobación claras y suficiente observabilidad para saber si las fallas provienen del código, la infraestructura o la cadena de dependencias.
Neoload no es la opción más ágil para una startup que valida una API REST simple. Pero si estás probando viajes de usuario amplios, aplicaciones empaquetadas o sistemas sensibles a la infraestructura, puede ahorrar tiempo que de otro modo desaparecería en la reparación de scripts y la interpretación de resultados.
7. Artillery
Artillery es una opción práctica para equipos de Node.js y programas de API que quieren algo más ligero que un conjunto empresarial pesado. Los escenarios en YAML hacen que las pruebas simples sean rápidas de escribir, y los hooks de JavaScript añaden flexibilidad cuando un flujo necesita valores dinámicos, configuración personalizada o validación de respuestas. Esa combinación es útil para ramas de características, verificaciones de nivel de servicio y puertas de rendimiento repetidas en CI.
Una plataforma de martech es un buen ajuste. Un equipo podría validar el registro de impresiones y la ingestión de eventos en cada rama. Otro podría ejercitar una API de registro regional antes de un lanzamiento de campaña. Artillery mantiene ese trabajo cerca de la pila de JavaScript existente.
Por qué los equipos eligen Artillery
Artillery se trata menos de ambición de protocolo amplio y más de velocidad de flujo de trabajo.
- YAML para escenarios comunes: Bueno para hacer que las pruebas útiles se ejecuten rápidamente.
- Extensibilidad de JavaScript: Útil cuando cadenas de solicitudes simples se convierten en flujos con estado.
- Orientación a microservicios: Funciona bien para sistemas centrados en HTTP que cambian a menudo.
"Mantén el script de prueba más simple que el servicio que estás probando." Si tu escenario de Artillery comienza a recrear toda tu máquina de estado de aplicación, la prueba se convertirá en el problema de mantenimiento.
Cuando la ubicación importa, las decisiones de enrutamiento deben permanecer explícitas. Si estás verificando cómo aterriza una campaña desde diferentes regiones, o si una regla de borde se comporta de manera diferente según el origen, una configuración de proxy de balanceo de carga puede ayudar a estructurar los caminos de tráfico. Pero eso aún no reemplaza la verdadera generación de carga distribuida. Solo cambia de dónde parecen venir las solicitudes.
Artillery no es la mejor respuesta para necesidades profundas de protocolo empresarial. Sin embargo, para servicios HTTP de rápido movimiento, es fácil de justificar.
8. BlazeMeter
BlazeMeter atrae a equipos que quieren ejecución distribuida sin ejecutar y mantener toda la infraestructura ellos mismos. Es especialmente atractivo cuando una empresa ya tiene activos de script y necesita una manera gestionada de ejecutarlos desde múltiples regiones, recopilar resultados y compartirlos entre equipos.
Ese modelo se ajusta a lanzamientos de comercio electrónico, validación de lanzamientos de fintech y verificaciones de capacidad de redes publicitarias donde el equipo quiere escala pero no quiere gastar su tiempo operando generadores de carga. La ejecución gestionada también puede reducir la fricción interna porque el entorno de prueba se vuelve más fácil de estandarizar.
Ejecución gestionada sin construir la red
BlazeMeter es útil cuando la gestión de infraestructura es la parte que tu equipo quiere evitar.
- Escala basada en la nube: Mejor para organizaciones que no quieren mantener generadores distribuidos.
- Informes compartidos: Más fácil socializar resultados entre ingeniería, QA y operaciones.
- Portabilidad de scripts: Útil para equipos que extienden prácticas de rendimiento existentes en lugar de comenzar de nuevo.
Un segundo problema práctico es la forma de costo. La cobertura independiente de 2026 señala que Grafana Cloud ofrece una asignación gratuita de 500 VUh, mientras que Locust y JMeter siguen siendo gratuitos a cualquier escala. Esa misma fuente dice que se proyecta que el mercado crecerá de $2.8 mil millones en 2025 a $7.1 mil millones para 2034 a un CAGR del 10.9%, y describe la demanda de las PYME como el segmento de más rápido crecimiento. La lección no es gratis versus pagado. Es que la ejecución repetida, la infraestructura del generador, el tiempo de scripting y la sobrecarga de integración deben ser todos valorados como un solo sistema.
BlazeMeter tiene sentido cuando la distribución gestionada es el cuello de botella. Si tu verdadero problema es un diseño de prueba débil o una mala observabilidad, un plano de control en la nube no solucionará eso.
9. WebLOAD
WebLOAD tiene una de las trayectorias históricas más claras en esta categoría. Se lanzó por primera vez en agosto de 1997, y su historial de versiones documentado incluye más de 20 lanzamientos, con hitos como pruebas de carga en la nube en 2012, soporte móvil e IPv6 en 2013, integración con Jenkins en 2013 y pruebas de WebSockets en 2014, como se resume en la historia documentada de WebLOAD. Esa línea de tiempo es importante porque muestra cómo las herramientas de pruebas de carga evolucionaron de simples verificaciones de estrés HTTP a plataformas más amplias vinculadas a la nube, CI/CD, móvil y protocolos modernos.
Para los profesionales, WebLOAD es interesante cuando el entorno mezcla flujos de trabajo similares a los de un navegador, APIs y amplias necesidades de entrega empresarial. Las cajas de pago minoristas, los portales de pacientes y los flujos de banca en línea a menudo caen en esa categoría porque las pruebas necesitan tanto flexibilidad en los scripts como mucho contexto diagnóstico.
Por qué WebLOAD sigue siendo relevante
Las herramientas de larga duración sobreviven porque resuelven problemas de mantenimiento de scripts y flujos de trabajo del equipo, no porque tengan la interfaz de usuario más llamativa.
- Modelo operativo híbrido: Útil para equipos que necesitan un IDE y opciones de ejecución en la nube.
- Soporte para viajes complejos: Mejor adaptado a caminos de aplicaciones pesadas en AJAX o con estado.
- Maturidad operativa: Integraciones como el soporte de CI importan más que el marketing una vez que las pruebas se vuelven rutinarias.
Una nota práctica. WebLOAD suele ser mejor cuando un equipo de rendimiento quiere más estructura de la que los marcos de código abierto suelen proporcionar, pero no quiere construir a mano cada parte del entorno de prueba. Es menos atractivo para un equipo pequeño con una API y una cultura fuerte de código primero.
10. Taurus
Taurus es menos un motor de carga que una capa unificadora. Eso es lo que lo hace valioso. Si un equipo usa JMeter, otro usa Locust y un tercero quiere estandarizar la ejecución de CI sin forzar una reescritura, Taurus puede suavizar eso a través de la configuración impulsada por YAML y el manejo de resultados.
Eso es útil en empresas, pero también en organizaciones más pequeñas donde la proliferación de herramientas ocurrió de manera natural. Un equipo de crecimiento puede tener un conjunto de JMeter heredado para puntos finales de campaña, mientras que un equipo de backend ejecuta verificaciones basadas en Python en otro lugar. Taurus le da a ambos grupos una manera de converger operativamente antes de converger técnicamente.
Dónde tiene sentido Taurus
Taurus es una opción práctica cuando la estandarización es más urgente que el reemplazo.
- Capa de ejecución unificada: Útil para organizaciones con múltiples motores en uso activo.
- Onboarding más simple: Nuevos colaboradores pueden comenzar con YAML en lugar de aprender toda la sintaxis nativa de una vez.
- Soporte de migración: Útil cuando los equipos están comparando motores o cambiando gradualmente la propiedad.
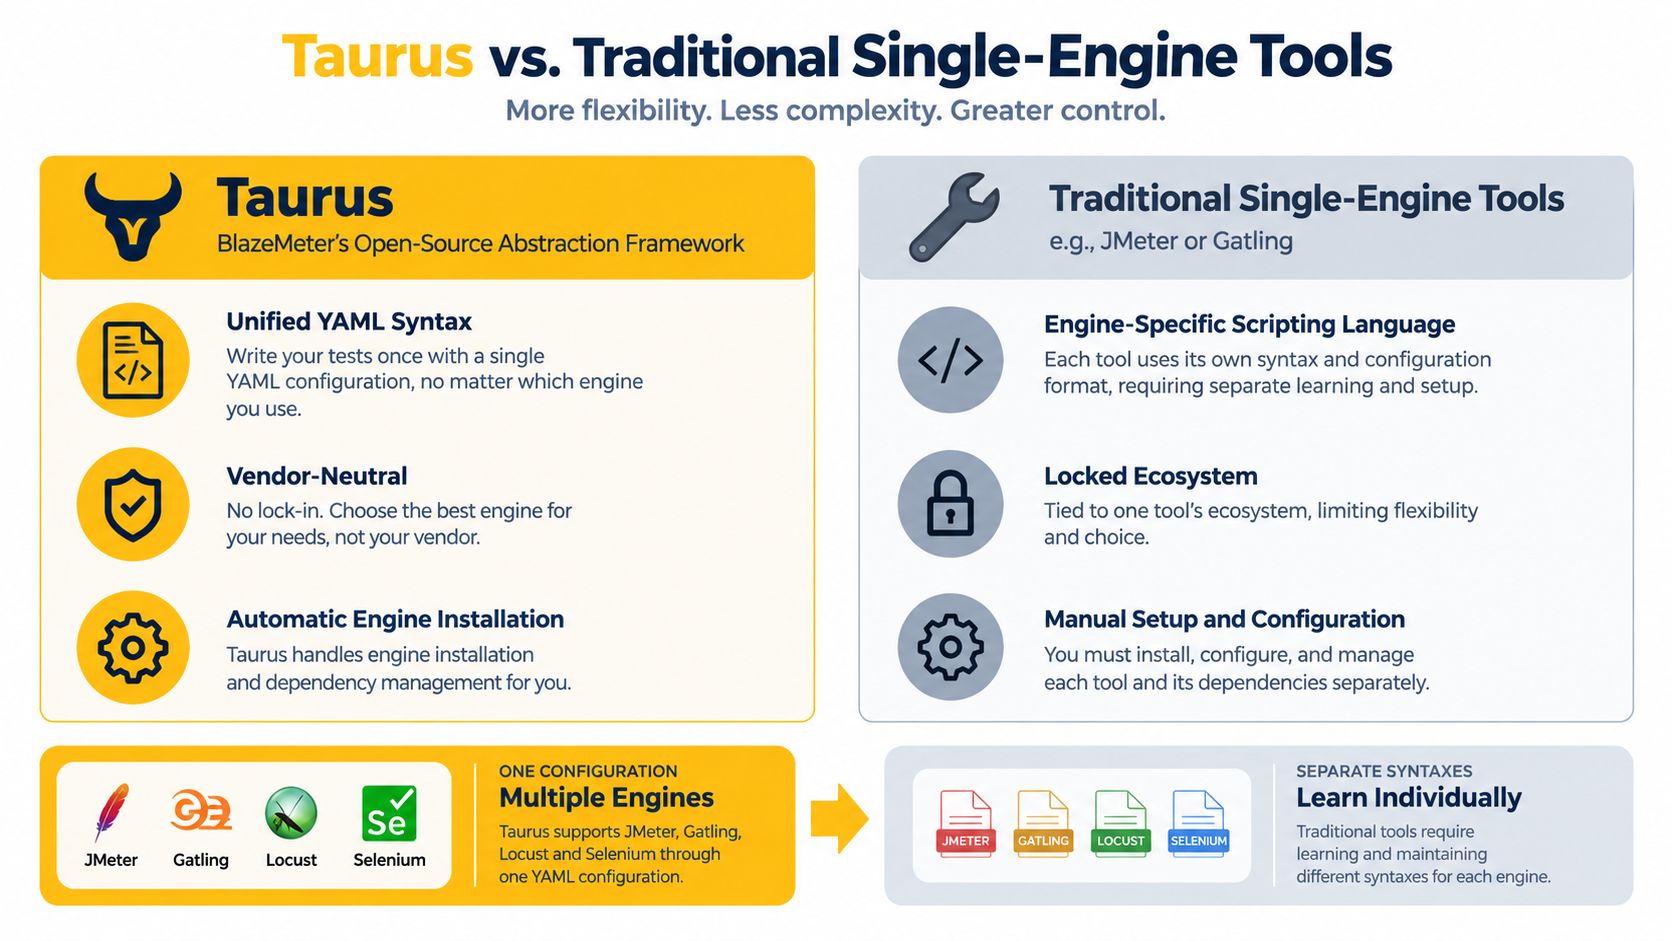
Una señal del mercado apoya por qué las capas de abstracción son importantes. Los datos de adopción independiente indican que más de 9,200 empresas utilizan herramientas de pruebas de rendimiento y carga, y JMeter solo representa aproximadamente el 56.30% de ese mercado rastreado, con 5,180 clientes, según el resumen de adopción citado en esta revisión de mercado. En términos simples, muchos equipos ya tienen JMeter en alguna parte. Taurus ayuda cuando el objetivo es organizar esa realidad en lugar de pretender que todos cambiarán de una vez.
No es una solución mágica. Si los scripts subyacentes son débiles, Taurus no los hará fuertes. Pero puede hacer que los entornos de herramientas mixtas sean mucho más fáciles de operar.
Comparación de las 10 principales herramientas de pruebas de carga
| Herramienta | Características principales | UX / Calidad (★) | Precio (💰) | Objetivo (👥) | Puntos de venta únicos (✨ / 🏆) |
|---|---|---|---|---|---|
| Apache JMeter | Muestreadores de múltiples protocolos (HTTP, FTP, JDBC, SOAP); pruebas distribuidas; complementos | ★★★★, informes maduros; curva de aprendizaje más pronunciada | 💰 Gratis, de código abierto | 👥 Equipos de QA, empresas, testers que necesitan amplitud de protocolos | ✨ Amplio soporte de protocolos y ecosistema de complementos; 🏆 gran comunidad |
| Gatling | Scala DSL, ritmo de usuario realista, carga eficiente en una sola máquina | ★★★★, código primero, excelente para desarrolladores; más difícil para no programadores | 💰 OSS gratis; Enterprise de pago | 👥 Equipos de desarrollo, CI/CD, ingenieros de rendimiento | ✨ Código como pruebas para escenarios reproducibles; alta eficiencia |
| LoadRunner | Grabación de VuGen, más de 50 protocolos, monitoreo y trazado del lado del servidor | ★★★★★, diagnósticos empresariales; interfaz compleja | 💰 Licenciamiento empresarial premium | 👥 Grandes empresas (finanzas, telecomunicaciones) | ✨ Análisis profundo de la causa raíz y cobertura de protocolos; 🏆 de nivel empresarial |
| Locust | Escenarios basados en Python, interfaz web, trabajadores distribuidos | ★★★★, muy fácil para usuarios de Python; iteración rápida | 💰 Gratis, de código abierto | 👥 Startups, equipos de Python, testers ágiles | ✨ Scripting simple en Python + control web en tiempo real |
| K6 | Pruebas en JavaScript, motor Go, escalado local/nube, umbrales | ★★★★, amigable para DevOps, integración suave con CI | 💰 OSS gratis + niveles de nube de pago | 👥 DevOps, desarrolladores de JS, pipelines de CI | ✨ Pruebas nativas de JS con escalado en la nube y métricas en tiempo real |
| Neoload | Diseño de pruebas asistido por IA, detección de anomalías de ML, integraciones ricas | ★★★★★, conocimientos de IA; poderoso pero complejo | 💰 Premium / empresarial | 👥 Grandes empresas, sistemas móviles y complejos | ✨ Correlación y optimización impulsadas por IA; 🏆 análisis avanzado |
| Artillery | Definiciones de pruebas en YAML/JS, soporte para WebSocket/SSE, bajo overhead | ★★★, rápido para comenzar; menos rico en características para empresas | 💰 OSS gratis; opciones de pago | 👥 Startups, equipos de Node.js, testers enfocados en API | ✨ Simplicidad primero en YAML; fácil uso en CI/CD |
| BlazeMeter | Escalado automático en la nube, compatibilidad con JMeter, scripting visual | ★★★★, sin infraestructura; generación de carga global | 💰 De pago (basado en uso en la nube) | 👥 Equipos que necesitan pruebas gestionadas a gran escala | ✨ Escalado gestionado + reutilización de JMeter; 🏆 fácil incorporación para equipos no de infraestructura |
| WebLOAD | Modos de IDE + nube, grabación de navegador, scripting similar a JS | ★★★★, grabador fuerte; flujo de trabajo centrado en IDE | 💰 Precios empresariales premium | 👥 Empresas con aplicaciones web complejas | ✨ Grabación precisa del navegador y desglose de transacciones |
| Taurus | Abstracción unificada en YAML para JMeter/Gatling/Locust/Selenium | ★★★, simplifica la orquestación; añade una capa de abstracción | 💰 Gratis, de código abierto | 👥 Organizaciones que estandarizan entre herramientas | ✨ YAML agnóstico al motor; ejecutar múltiples motores desde una configuración |
Convierta la lista corta en un plan de prueba responsable
La elección de herramientas se vuelve más fácil cuando comienzas desde el flujo de trabajo, no desde la marca. Elige Apache JMeter cuando necesites una amplia cobertura de protocolos y sin costo de licencia. Escoge Gatling o K6 cuando el equipo quiera pruebas de código primero que se integren de manera natural en CI/CD. Usa Locust o Artillery cuando la cultura de ingeniería sea fuertemente Python o Node.js y el objetivo sea principalmente tráfico HTTP o API. Opta por LoadRunner, Neoload o WebLOAD cuando los diagnósticos empresariales, la grabación o las realidades de protocolos más amplios importen más que herramientas minimalistas. BlazeMeter se adapta a la ejecución distribuida gestionada. Taurus es relevante cuando ya existen múltiples motores y necesitas una capa operativa única entre ellos.
La decisión más importante es cómo ejecutar la prueba. Comienza definiendo el objetivo legítimo. Valida la estabilidad del proceso de pago, la entrega de anuncios regionales, la resiliencia del registro de cuentas, el manejo de ráfagas de API, o cualquier otro camino comercial concreto. No empieces con “ver cuánto tráfico puede soportar.” Eso generalmente crea datos ruidosos y ninguna decisión útil.
Utilice entornos de prueba siempre que sea posible, o utilice ventanas de producción aprobadas con una clara propiedad y planes de reversión. Establezca una línea base primero, luego establezca umbrales de aprobación y fallo para latencia, errores y rendimiento. Decida qué regiones son importantes. Una campaña geo-sensible, un flujo de precios localizado o un viaje de cumplimiento específico de un país pueden justificar pruebas basadas en regiones. Una API interna genérica generalmente no lo hará.
Los proxies pertenecen solo a las partes del plan donde la identidad de origen cambia el comportamiento del sistema. Las IPs de centros de datos son adecuadas para muchas ejecuciones de carga en backend y suelen ser la opción más sencilla. Las IPs residenciales son útiles cuando necesita orígenes que parezcan de consumidores. Los proxies móviles resuelven un problema más específico. Son relevantes cuando necesita validar experiencias dependientes de la red móvil, comportamientos sensibles a los operadores o patrones de identidad regional que difieren de la banda ancha fija.
Esa distinción es importante porque las IPs móviles 4G y 5G son más difíciles de bloquear con reglas simples de IP. Los operadores colocan a muchos suscriptores detrás de NAT de grado operador, por lo que una IP móvil puede representar grandes cantidades de usuarios reales, lo que hace que el bloqueo basado en IP sea arriesgado y empuja a los sistemas hacia la detección de comportamiento en su lugar, como se explica en esta visión general de NAT de grado operador y rangos de proxies móviles. Si su aplicación se comporta de manera diferente para el tráfico de origen móvil, esa es una variable de QA válida. Si no lo hace, agregar IPs móviles puede complicar el análisis.
Lo mismo ocurre con las elecciones de protocolo y sesión. Los proxies HTTP(S) suelen ser suficientes para el tráfico web estándar. SOCKS5 es más flexible cuando necesita un modelo de proxy de transporte más amplio, y los servicios a menudo ofrecen ambos juntos, como se describe en esta visión general de protocolos de proxy. Luego decida si necesita rotación o continuidad. Las sesiones rotativas cambian las IPs con frecuencia y son adecuadas para la recolección de alto volumen o muestreo amplio. Las sesiones fijas mantienen la misma IP de salida durante un período definido, lo que es mejor para flujos basados en inicio de sesión, estado de cuenta y cualquier viaje que dependa de la continuidad de la sesión, como se describe en esta guía sobre sesiones rotativas y fijas.
Monitoree el comportamiento de la aplicación y los efectos del proxy por separado. Eso significa rastrear los tiempos de respuesta, el rendimiento y los errores de la herramienta de carga mientras también observa si la ruta del proxy agrega latencia, cambia encabezados o altera la resolución geográfica. Documente el consentimiento, las ventanas de uso aprobadas y las restricciones de los Términos de Servicio antes de cualquier prueba que toque plataformas de terceros o propiedades públicas. La automatización responsable siempre tiene un propósito comercial y límites explícitos.
Si su equipo necesita QA dependiente de la geografía, validación de campañas regionales, investigación de mercado u otros flujos de trabajo sensibles a la origen, Evoproxy es una opción a evaluar junto con las herramientas de prueba de carga en sí. La pila adecuada suele ser una combinación: una herramienta para generar carga, una capa de monitoreo para diagnóstico y un enfoque de proxy solo donde la geografía o la identidad de la red pertenecen a la prueba.
Si necesita IPs móviles francesas para QA dependiente de la geografía, validación de campañas, investigación de mercado o pruebas de flujos de trabajo de múltiples cuentas, Evoproxy ofrece conectividad móvil 4G diseñada para esos escenarios sensibles a la origen. Vale la pena evaluarlo cuando su plan de prueba dependa de la identidad real de la red móvil en lugar de tráfico genérico de centros de datos. Visite Evoproxy para ver si sus proxies móviles 4G se ajustan a su flujo de trabajo específico.


